Valse meldingen van AI-detectors: van grondwet tot studenten
Van de Amerikaanse grondwet tot onterechte beschuldigingen van studenten: waarom AI-detectors geen sluitend bewijs leveren en hoe je ermee omgaat.
👁 116 keer gelezen
Een AI-detector heeft je tekst aangemerkt als gegenereerd door kunstmatige intelligentie. Is dat voldoende om een nul te geven, een manuscript af te wijzen of een auteur te beschuldigen van fraude? Nee. De score van een AI-detector is hooguit een aanwijzing die verificatie vereist, geen zelfstandig bewijs van auteurschap. Dat blijkt overduidelijk uit ervaringen van studenten, besluiten van universiteiten en het bekende voorbeeld van de Amerikaanse grondwet.
Hieronder scheid ik gedocumenteerde foute meldingen van kwesties waarin de handelwijze van instellingen ter discussie kwam te staan. Dat is een belangrijk onderscheid: een vernietigde sanctie is niet automatisch een laboratoriumbewijs dat de detector ernaast zat. Bronstatus: 14-10-2026. Dit artikel is gebaseerd op officiële documenten en publicaties.
Afzonderlijk beschrijf ik de zaak rond de bekroonde roman en beschuldigingen op basis van een AI-detector.
Wat betekent een vals positieve uitslag bij een AI-detector?
Een vals positieve uitslag (false positive) treedt op wanneer een programma een door een mens geschreven tekst toeschrijft aan kunstmatige intelligentie. Iets heel anders is het correct opmerken van toegestane AI-ondersteuning, zoals een taalkundige correctie of spellingcheck. In dat laatste geval draait de discussie om de geldende regels, niet om de nauwkeurigheid van de software.
Dit onderscheid wordt benadrukt in het overzichtsartikel van Victor Angelier van 18-09-2026. De auteur wijst erop dat een detector uitsluitend de kenmerken van de uiteindelijke tekst analyseert, zonder het daadwerkelijke schrijfproces te kunnen observeren. De uitslag zelf bewijst dus nooit wat een specifieke persoon precies heeft gedaan en of diegene regels heeft overtreden.
Voordat je oordeelt over een spraakmakend geval, stel je drie vragen: kennen we de daadwerkelijke herkomst van de tekst, welke tool is exact gebruikt en wat is er uiteindelijk vastgesteld? Zonder die feiten haal je al snel een losse schermafbeelding op sociale media, een beschuldiging van een docent en een formele uitspraak door elkaar, terwijl dat compleet verschillende dingen zijn.
Amerikaanse grondwet en de Bijbel aangemerkt als AI
In een artikel van Ars Technica van 14-07-2023 werd gedemonstreerd dat passages uit de Amerikaanse grondwet door GPTZero en ZeroGPT werden aangemerkt als AI-gegenereerd. ZeroGPT bestempelde een fragment uit Genesis eveneens als machinaal geschreven. Het betrof specifieke tekstfragmenten en de scores van de detectietools uit die periode, geen alomvattend onderzoek naar alle historische documenten.
Dit voorbeeld leert ons vooral voorzichtig te zijn met dergelijke labels. Een AI-detector kan immers niet bepalen wanneer een document daadwerkelijk is geschreven. Het bewijst overigens niet dat elke hedendaagse versie van deze tools exact hetzelfde reageert; ik heb deze historische test zelf niet herhaald.
Zie dergelijke voorbeelden als een belangrijk waarschuwingssignaal. Ze tonen aan dat fouten voorkomen, maar vertellen je niets over het foutenpercentage bij opdrachten in jouw klas of manuscripten bij een uitgeverij. Daarvoor is een representatieve steekproef van teksten met een geverifieerde herkomst nodig, samen met een transparant evaluatieproces.
Texas A&M University-Commerce: een chatbot als fraudedetector
In mei 2023 plakte een docent aan de Texas A&M University-Commerce opdrachten van studenten rechtstreeks in ChatGPT met de vraag of de chatbot ze had geschreven. Volgens de verslaggeving van NBC News van 18-05-2023, eveneens gepubliceerd via AOL, dienden de antwoorden van de chatbot als basis om werk af te keuren. Dit was geenszins een test met een gespecialiseerde AI-detector.
De universiteit nuanceerde later het gerucht dat de hele groep was gezakt en niemand mocht afstuderen. Er werd melding gemaakt van tijdelijke onvolledige beoordelingen. Volgens een officiële verklaring van de instelling werden diverse studenten vrijgepleit, gaf één student toe ChatGPT tijdens de cursus te hebben gebruikt en kozen anderen voor een vervangende opdracht.
De conclusie is dan ook niet dat elke claim direct onzin was; het probleem lag in de ondeugdelijke methode, die volstrekt ontoereikend was voor een collectief eindoordeel. Het toont ook het belang aan van het controleren van officiële verklaringen van onderwijsinstellingen in plaats van het overnemen van sensationele berichten.
Voor docenten is dit een duidelijke les: het bevestigende antwoord van een taalmodel op de vraag of het een tekst heeft geschreven, zegt niets over de acties van de student. Zonder aanvullend bewijs is een dergelijk antwoord hooguit een aanleiding voor een gesprek, nooit een eindoordeel.
Vanderbilt: waarom de universiteit AI-detectie uitschakelde
Vanderbilt University maakte op 16-08-2023 bekend dat zij de AI-detectiefunctie in Turnitin uitschakelde. De instelling wees onder meer op het aanzienlijke risico op valse beschuldigingen, het gebrek aan transparantie rond het algoritme en de onevenredige impact op studenten voor wie Engels de tweede taal is.
De universiteit zette het destijds door de leverancier geclaimde foutenpercentage van 1% af tegen de circa 75.000 werkstukken die een jaar eerder waren ingediend. De berekende 750 teksten waren een illustratie van het potentiële risico; het betekende uiteraard niet dat er daadwerkelijk 750 studenten onterecht waren veroordeeld.
Dit onderscheid is cruciaal voor een zuivere discussie. Je kunt een theoretisch foutenpercentage doorrekenen naar een aantal documenten, maar een rekensom is geen opsomming van werkelijke slachtoffers. Daarnaast moet je altijd kijken naar de specifieke testcondities waarop dat percentage van toepassing is.
De praktische les voor scholen en universiteiten: weeg de gevolgen van een foute melding zorgvuldig af vóórdat je geautomatiseerde controlesystemen aanzet. Zelfs een rooskleurige claim over betrouwbaarheid vervangt niet het antwoord op de vraag hoe bezwaren worden afgehandeld en hoe het hoor- en wederhoor is geregeld.
Newby v. Adelphi University: wat de rechter daadwerkelijk besliste
In de rechtszaak Matter of Newby v Adelphi University, beslist op 28-01-2026, vocht een student een formele sanctie wegens academisch wangedrag aan. Uit de rechtbankdocumenten blijkt dat Turnitin een score van 100% aangaf. De student ontkende fel en overlegde tegenstrijdige resultaten van andere detectiesoftware.
Adelphi verdedigde de beslissing door te wijzen op redelijke gronden en het volgen van de geldende interne procedures. De rechter vernietigde echter de vaststelling van fraude en de afwijzing van het beroep, beval het schrappen van de aantekening en hief de sancties op. De motivering richtte zich zowel op de wankele bewijskracht als op ernstige procedurele gebreken, waaronder het negeren van door de student aangedragen ontlastend materiaal en het belemmeren van een eerlijke beroepsprocedure.
Dit betekende geen algeheel verbod op AI-detectors en evenmin een gerechtelijk oordeel over de werking ervan. De uitspraak onderstreept simpelweg dat een onderwijsinstelling haar eigen regels zorgvuldig moet naleven en open moet staan voor verweer. Een lage score bij een alternatieve detector is op zichzelf ook geen automatisch bewijs van onschuld. Ik beschrijf hier puur de inhoud van deze specifieke uitspraak, zonder aannames over eventuele verdere juridische procedures.
De belangrijkste les voor studenten: baseer je bij bezwaar niet uitsluitend op een tegenrapport van een andere detector. Bouw een heldere tijdlijn op, leg overgeslagen bewijsstukken over en vraag om een concrete toelichting op welk specifiek artikel uit het reglement overtreden zou zijn.
Wat we leren over het controleren van auteurschap
Het fundamentele probleem ontstaat zodra een statistische waarschijnlijkheid in de plaats treedt van een zorgvuldig feitenonderzoek. Een softwarematige score mag slechts een beginpunt zijn, maar door de manier waarop percentages worden gepresenteerd, krijgt het vaak de schijn van een onomstotelijk vonnis.
Het onderzoek van Debora Weber-Wulff en collega’s, gepubliceerd op 21-06-2023, evalueerde 14 detectietools en bracht grote betrouwbaarheidsproblemen aan het licht. Fouten traden op in beide richtingen: menselijke tekst werd als AI gezien en AI-tekst werd niet opgemerkt. Dit benadrukt de noodzaak om methoden kritisch te blijven toetsen, al kun je hier niet één universeel foutenpercentage voor alle tools in 2026 uit afleiden.
- Onderscheid een signaal van een vaststaand feit. De formulering “de software markeert de tekst” is feitelijk juist; “de auteur heeft AI gebruikt” is een aanname.
- Controleer wat er precies is gescand. Een losse alinea, een volledig werkstuk of een versie na correctie leveren totaal verschillende scores op.
- Noteer datum, software en versienummer. Zonder deze details is een resultaat niet te reproduceren of controleren.
- Lees de opdrachtinstructies na. Toegestane vormen van ondersteuning, zoals vertaal- of spellingstools, moeten los worden beoordeeld van fraude.
- Zorg voor hoor en wederhoor. De auteur moet de kans krijgen om inhoudelijk te reageren op de specifieke aantijging en de gebruikte data.
Een gerelateerd knelpunt behandel ik in het artikel over AI-detectors en schrijven in een tweede taal. Daarnaast laten de reglementen van literaire schrijfwedstrijden en uitgeverijen zien waarom niet elke vorm van digitale hulp over één kam geschoren kan worden.
Wat te doen bij een onterechte AI-beschuldiging?
Het onderstaande stappenplan helpt je om je verweer overzichtelijk op te bouwen, zonder garantie op de uiteindelijke uitkomst. Begin altijd met het veiligstellen van je documenten in hun oorspronkelijke staat. Ga een tekst niet haastig herschrijven om een lagere score te forceren; daarmee wis je het vertrekpunt van de discussie uit.
- Vraag om het volledige analyserapport, de exacte naam van de gebruikte tool, de scandatum en het onderzochte bestand.
- Verzamel je concepten, aantekeningen, bronnenlijsten en de bewerkingsgeschiedenis van je tekstverwerker.
- Licht open toe welke hulpmiddelen je hebt ingezet: van overleg en spellingcontrole tot vertaalprogramma’s of AI-hulp.
- Koppel je bewijsmateriaal direct aan specifieke passages in de tekst, in plaats van een ongeordende map met bestanden in te leveren.
- Raadpleeg de Onderwijs- en Examenregeling (OER) of het examenreglement voor bezwaartermijnen en procedures.
- Vraag om een schriftelijke onderbouwing van het besluit en een reactie op jouw ingediende argumenten.
Ga achteraf geen documenten manipuleren om eerdere tussenversies na te bootsen. Als je in één enkel bestand hebt gewerkt zonder automatische versiegeschiedenis, wees daar dan eerlijk over. Je kunt alsnog je denkproces uiteenzetten, de keuze voor specifieke bronnen toelichten of verwijzen naar personen met wie je de stof hebt besproken. Elk bewijsstuk moet in context worden gewogen; geen enkel document biedt op zichzelf absolute zekerheid over auteurschap.
Voor beoordelaars geldt: scheid inhoudelijke vakkennis van mondelinge welbespraaktheid. Een mondeling toelichtend gesprek is bedoeld om te toetsen hoe ideeën en argumenten tot stand zijn gekomen, niet om de stressbestendigheid van de student te testen. Bepaal vooraf welke inhoudelijke vragen je wilt stellen en geef de schrijver de tijd om claims te onderbouwen met documenten.
Het is bovendien raadzaam helder te benoemen wat de beschikbare gegevens níet aantonen. Een versiegeschiedenis toont tussenstappen, maar verklaart niet per se de herkomst van elke geplakte zin. Een kladbloknotitie bewijst voorbereiding, maar zegt weinig over de uiteindelijke redactieslag. Eis geen onmogelijk, sluitend bewijs, maar beoordeel de samenhang tussen de chronologie, de opzet, de bronnen en het mondelinge verhaal. Maak in de beoordeling een scherp onderscheid tussen wat vaststaat en wat onzeker blijft.
Mijn test uit oktober 2026: ook klassiekers krijgen het label “AI”
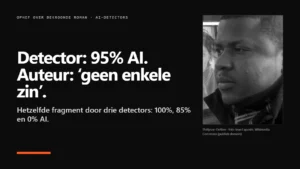
Een soortgelijk effect zag ik op 14 oktober 2026, toen ik fragmenten uit de roman van Thélyson Orélien samen met controlefragmenten onderzocht. AUTHORRA bestempelde een fragment uit “Germinal” van Émile Zola uit 1885 voor 91,6% als AI-gegenereerd, terwijl ZeroGPT aan “Le Horla” van Guy de Maupassant uit 1887 een score van 26,4% AI toekende. Pangram herkende beide controlefragmenten wel correct als menselijk werk. Alle testresultaten en schermafbeeldingen lees je in het artikel over de zaak-Thélyson Orélien en de AI-detector.
Ben je zelf geconfronteerd met een valse melding? Bekijk dan het concrete stappenplan in de gids over onterecht beschuldigd van AI-gebruik: wat kun je doen?.
Veelgestelde vragen
Is een score van 100% in een AI-detector het bewijs van fraude?
Nee. Je moet altijd nagaan hoe die score is opgebouwd, onder welke omstandigheden de analyse is uitgevoerd en wat het werkelijke totstandkomingsproces van de tekst is geweest. Een hoge score bewijst op zichzelf noch AI-auteurschap, noch een overtreding van het reglement.
Werd de Amerikaanse grondwet echt aangemerkt als AI?
Ja, dergelijke uitslagen voor delen van de grondwet zijn vastgelegd in het genoemde artikel van Ars Technica uit juli 2023. Die historische tests moeten echter niet worden verward met de huidige werking van alle moderne detectietools.
Is het controleren met een tweede AI-detector voldoende verweer?
Een tweede rapport kan een afwijkende score aantonen, maar verklaart de oorzaak van het verschil niet. Het overleggen van concreet procesbewijs (zoals eerdere versies, bronnen en notities) is bij een geschil vele malen effectiever.
Heeft de rechterlijke uitspraak in de zaak-Adelphi AI-detectors verboden?
Nee. Het vonnis betrof uitsluitend de specifieke handelswijze en procedurele gebreken van de universiteit in kwestie. De uitspraak verbiedt dergelijke tools niet algemeen, noch stelt ze dat elke meting per definitie onjuist is.
Betekent het ontbreken van een versiegeschiedenis dat er AI is gebruikt?
Nee, dat ontbreken levert op zichzelf geen enkel bewijs van AI-gebruik op. Wees transparant over je feitelijke werkwijze en presenteer de bewijsmaterialen die je wél hebt, zonder achteraf ontbrekende versies in elkaar te zetten.
Bronnen
- Victor Angelier, The pitfalls of AI detection in academic writing - 18-09-2026; geraadpleegd 14-10-2026.
- Benj Edwards, Ars Technica, artikel over detectietools en de Amerikaanse grondwet - 14-07-2023; geraadpleegd 14-10-2026.
- Uwa Ede-Osifo en Kalhan Rosenblatt, NBC News, verslag via AOL - 18-05-2023; geraadpleegd 14-10-2026.
- Vanderbilt University, toelichting op het uitschakelen van de Turnitin AI-detector - 16-08-2023; geraadpleegd 14-10-2026.
- Matter of Newby v Adelphi University, 2026 NY Slip Op 26021 - rechterlijke uitspraak 28-01-2026; geraadpleegd 14-10-2026.
- Debora Weber-Wulff et al., Testing of Detection Tools for AI-Generated Text - preprint 21-06-2023; geraadpleegd 14-10-2026.
More on this from HELDER

 ai-tools·AI-detectors: hoe ze werken, betrouwbaarheid en prijzenHoe betrouwbaar zijn AI-detectors echt? Alles over de werking, valse positieven, prijzen en wat je moet doen als een detector jouw tekst aanwijst.