Gemma 4 31B lokaal op RTX 4090: benchmarks, VRAM en prestaties
Gemma 4 31B lokaal draaien in Ollama op een RTX 4090: haal 42 tok/s, verbruik 19 GB VRAM en ontdek de prestaties, installatie en valkuilen.
👁 114 keer gelezen
Gemma 4 31B van Google is het krachtigste dichte model met open gewichten dat nog volledig op een enkele RTX 4090 past. We installeerden het via Ollama op ons testsysteem: het genereert ongeveer 42 tokens per seconde en scoorde 9,5 uit 10 in onze meertalige taaltests, maar het eist vrijwel de volledige 24 GB videogeheugen op en stelt zware eisen aan je opslag. Dit is de eerste aflevering in onze reeks over lokale modellen op je eigen pc.
Stand van zaken op 8 oktober 2026
- Model:
gemma4:31b-it-qatin Ollama 0.40.1 (versie met quantization-aware training, bestand van 17,65 GB + 1,2 GB voor de beeldmodule). - Licentie: Apache 2.0 - commercieel gebruik toegestaan.
- Snelheid: 40,7-43,4 tok/s bij genereren, circa 870-1240 tok/s bij promptverwerking.
- Videogeheugen: 19,2 GB volgens Ollama, piekbelasting op de hele kaart 24,0 GB (nvidia-smi).
- Taalprestaties: 9,5/10 in onze 5 testtaken (getest in het Pools).
- Downloadtijd: 40 min en 41 s. Laadtijd vanaf usb-opslag: van 1 min 53 s tot 14 min 33 s.
Waarom Gemma 4 31B als eerste aan de beurt is
We nemen een open model, starten het op een RTX 4090 (24 GB VRAM, Windows 11) en meten telkens dezelfde aspecten: installatie, laadtijd, inferentiesnelheid, geheugengebruik, taalvaardigheid en de licentievoorwaarden. We bekeken eerst recent verschenen alternatieven, maar die vielen vrijwel allemaal af:
- Ling 3.1 Flash - telt 560 miljard parameters en heeft nog geen open gewichten (we bespraken dit model eerder in onze analyse van Ling 3.1 Flash).
- Mistral Small 4 - bevat ondanks de naam 119 miljard parameters en past zelfs met zware kwantisatie niet in 24 GB.
- GLM 5.3 - er is geen “Air”-versie beschikbaar en de kleinste variant, GLM-5.3 Flash, telt al 320 miljard parameters.
- Hy Image 3.5 - Tencent biedt enkel een API-preview aan zonder downloadbare gewichten.
- Qwen 3.8 27B - kwam al uitgebreid aan bod in onze vergelijking van 7 lokale modellen.
Gemma 4 31B is sinds het voorjaar beschikbaar, maar ontbrak nog in onze directe hardwarebenchmarks. Het is het grootste model binnen de Gemma 4-familie en het enige dichte model van dit kaliber dat je op een enkele consumentenvideokaart kunt draaien.
Specificaties van het model
| Eigenschap | Gemma 4 31B |
|---|---|
| Ontwikkelaar | Google DeepMind |
| Parameters | 30,7 miljard, dicht model (alle parameters actief bij elk token) |
| Contextvenster | tot 256.000 tokens |
| Invoer en uitvoer | tekst en beeld als invoer; uitsluitend tekst als uitvoer |
| Talen | meer dan 140 talen in de trainingsdata, circa 35 direct ondersteund volgens Google |
| Licentie | Apache 2.0 |
| Beschikbaar in Ollama | gemma4:31b-it-qat (Q4_0, 19 GB), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 GB) |
| Aanbevolen instellingen | temperature 1.0, top_p 0.95, top_k 64 |
De QAT-versie is getraind met het oog op 4-bits kwantisatie en behoudt daardoor meer kwaliteit dan een standaard Q4-conversie achteraf. Voor een kaart met 24 GB VRAM is dit de enige realistische keuze, want de q8-variant vereist al meer dan 30 GB.
Onze metingen op de RTX 4090
| Meting | Resultaat | Opmerkingen |
|---|---|---|
| Downloaden (18,2 GB) | 40 min 41 s | downloadsnelheid varieerde tussen 4 en 29 MB/s |
| Eerste laadpoging | time-out na 5 min | foutmelding “timed out waiting for llama-server to start” - zie uitleg hieronder |
| Laden vanaf externe usb-schijf | 8 min 32 s en 14 min 33 s | D:-schijf via usb, doorvoersnelheid circa 44-66 MB/s |
| Laden vanuit systeemcache | 1 min 53 s | het modelbestand stond nog in het werkgeheugen na de vorige sessie |
| Genereren (5 taken) | 40,7-43,4 tok/s | contextlengte 8.192 tokens, zonder denkmodus |
| Lange tekst (1.438 tokens) | 41,3 tok/s | circa 800 woorden gegenereerd in 35 s |
| Genereren bij context van 32.768 | 42,2 tok/s | geen merkbaar prestatieverlies |
| Promptverwerking | 870-1240 tok/s | de allereerste query verliep trager (24 tok/s als opstart) |
| VRAM volgens Ollama | 19,2 GB (8k) / 19,3 GB (32k) | 100% toegewezen aan GPU |
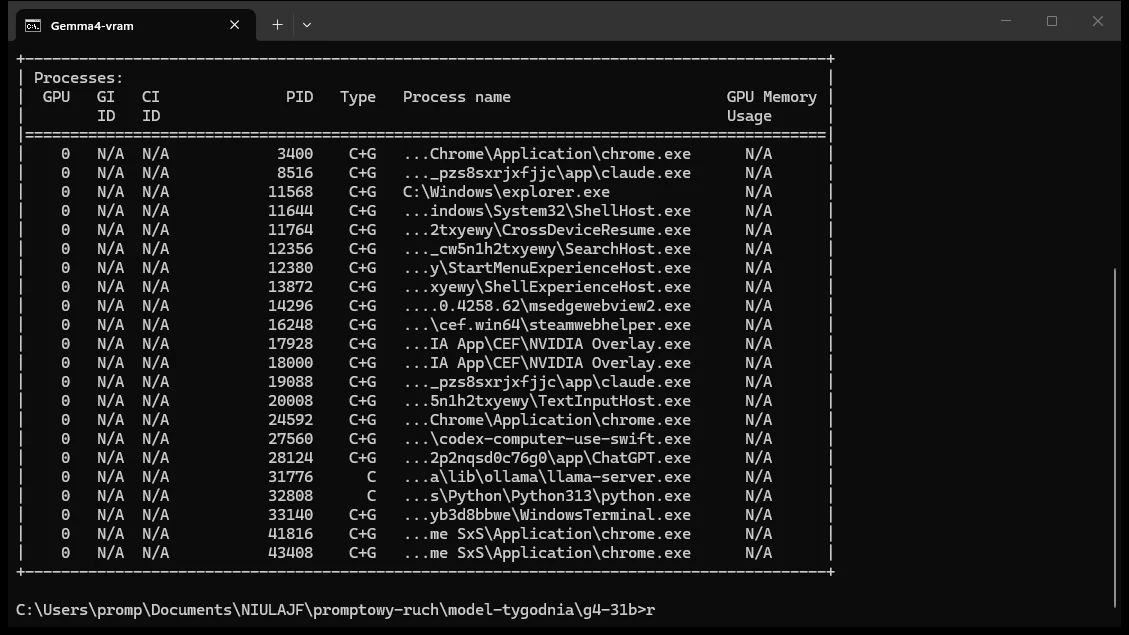
| Totaal GPU-geheugen via nvidia-smi | 21,8 GB na inladen, piek van 24,0 GB | inclusief Windows-bureaublad en browser (circa 0,8 GB vooraf) |
Een snelheid van 41 tot 43 tokens per seconde is sneller dan de meeste mensen kunnen lezen. Ter vergelijking: in onze eerdere test van lokale modellen haalde de compactere Gemma 4 12B zo’n 104 tok/s op 8 GB VRAM. Qwen 3.8 27B werkte ongeveer half zo snel als de 12B en verbruikte 17 GB. De 31B is daarmee de traagste van deze drie, maar leent zich nog uitstekend voor interactieve gesprekken.
Belangrijke les: deel de videokaart niet met andere software
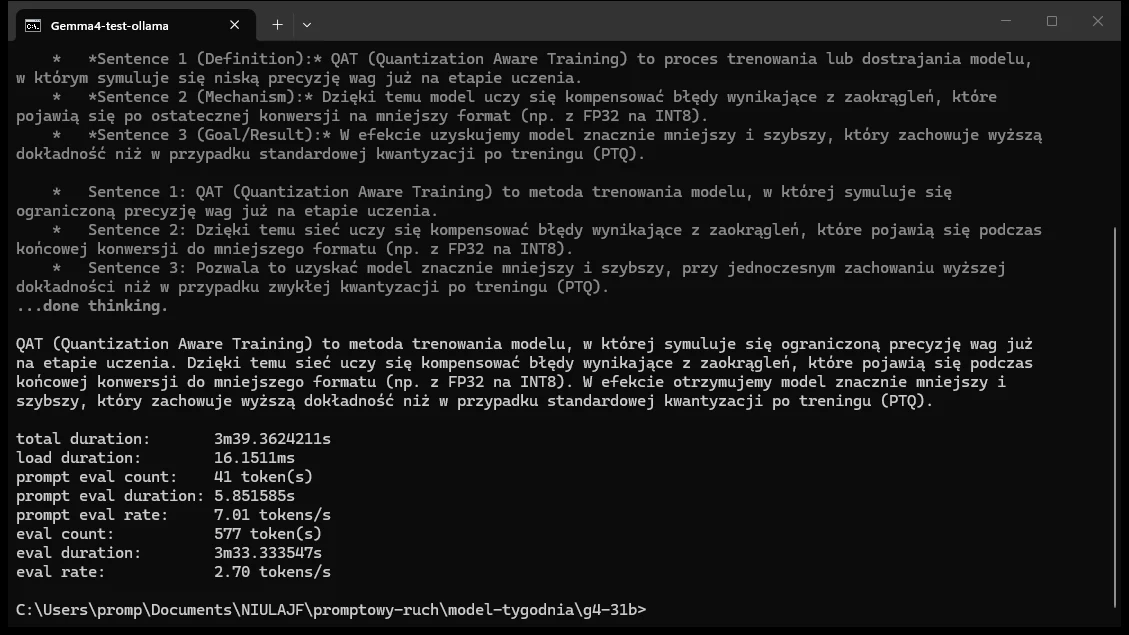
Tijdens het vastleggen van schermafbeeldingen startte er op de achtergrond een beeldgeneratie in ComfyUI op dezelfde videokaart. Het videogeheugen raakte direct verzadigd (23,9 van de 24 GB bezet), waardoor Windows gegevens naar het reguliere werkgeheugen verplaatste. De snelheid zakte onmiddellijk in van 42 naar 2,7 tok/s, en bij een volgende poging zelfs naar 0,5 tok/s. Gemma 4 31B laat geen speelruimte over: je kunt er geen beeldmodel naast draaien, en zelfs een browser met veel open tabbladen kan al roet in het eten gooien.
Gemma 4 31B getest: 5 taken in het Pools
We hebben het model aan de tand gevoeld met een vaste benchmark van 5 complexe taken in het Pools. Dezelfde set leggen we voor aan elk volgend model in deze serie om de prestaties onderling te vergelijken. Elke opdracht krijgt een score van 0 tot 2 punten.
| Opdracht | Score | Bevindingen |
|---|---|---|
| E-mail met excuses (lastige eigennamen en verbuigingen) | 1,5/2 | correcte grammaticale verbuiging van plaatsnaam, kortingscode toegevoegd, maar ontweek de achternaam |
| Tekstcorrectie met 8+ fouten | 2/2 | vond alle fouten: spelfouten, ontbrekende diakritische tekens en 5 ontbrekende komma’s |
| Factuurberekening: 3 posten met 23% en 5% btw | 2/2 | btw 1314,00, totaalbedrag inclusief btw 7073,90 - klopt tot op de cent nauwkeurig |
| 5 feitelijke vragen over geografie en geschiedenis | 2/2 | alle feiten correct beantwoord (steden, auteur, berghoogte, jaartal, regio’s) |
| 3 taaleigen uitdrukkingen met contextzinnen | 2/2 | nauwkeurige betekenissen en natuurlijke voorbeelden |
| Totaal | 9,5/10 |
We merkten twee formele eigenaardigheden op: het model gebruikt graag uitgebreide Markdown en zette bij de tekstcorrectie pijlen neer in LaTeX-notatie ($rightarrow$), wat in een standaard terminalvenster niet netjes rendert. In de ingebouwde denkmodus (standaard actief in ollama run) formuleert het model zijn interne denkstappen in het Engels voordat het de uiteindelijke reactie in de gevraagde doeltaal produceert.
E-mail met excuses - volledige reactie van het model (185 tokens, 42,5 tok/s)
Geteste prompt: Napisz krótki e-mail (do 120 słów) do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna, z przeprosinami za 5-dniowe opóźnienie dostawy krzesła biurowego. Zaproponuj rabat 10% na kolejne zamówienie. Ton uprzejmy, bez przesady. Użyj poprawnej odmiany nazwiska i nazwy miejscowości. (Vertaling: Schrijf een korte e-mail van maximaal 120 woorden aan een klant met excuses voor 5 dagen vertraging bij de levering van een bureaustoel en bied 10% korting op de volgende bestelling.)
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Tekstcorrectie - volledige reactie van het model (306 tokens, 40,7 tok/s)
Geteste prompt: Popraw błędy w tekście i wypisz listę poprawek (każda w osobnym punkcie: było -> jest). Tekst: “Wczoraj poszłem do sklepu żeby kupić chleb, ale okazało się że był zamknięty. W poniedziałek napewno pójde jeszcze raz, bo mam nadzieje że będzie otwarte. Moja koleżanka która tam pracuje mówiła, że wogóle nie zamykają przed 18.” (Vertaling: Verbeter de taalfouten in de tekst en toon een overzicht van alle correcties.)
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $rightarrow$ na pewno (pisownia rozdzielna)
* pójde $rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $rightarrow$ w ogóle (pisownia rozdzielna)
Factuurberekening - volledige reactie van het model (176 tokens, 41,4 tok/s)
Geteste prompt: Policz fakturę. Pozycje netto: laptop 4200,00 (VAT 23%), książka 59,90 (VAT 5%), usługa szkolenia 1500,00 (VAT 23%). Podaj VAT dla każdej pozycji, sumę netto, sumę VAT i sumę brutto. Kwoty zaokrąglaj do grosza. Na końcu jedna linia: BRUTTO = … (Vertaling: Reken de factuur uit met de opgegeven nettobedragen en btw-percentages, rond af op centen en geef de totalen.)
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 $rightarrow$ VAT (23%): 966,00
*   Książka: netto 59,90 $rightarrow$ VAT (5%): 3,00
*   Usługa szkolenia: netto 1500,00 $rightarrow$ VAT (23%): 345,00

Suma netto: 5759,90
Suma VAT: 1314,00
Suma brutto: 7073,90

BRUTTO = 7073,90
Feitelijke kennisvragen - volledige reactie van het model (60 tokens, 43,4 tok/s)
Geteste prompt: Odpowiedz krótko na 5 pytań, każde w jednej linii: 1) Jakie miasta są siedzibami władz województwa lubuskiego? 2) Kto napisał “Lalkę”? 3) Jak wysoki jest najwyższy szczyt Polski i jak się nazywa? 4) W którym roku odbyła się bitwa pod Grunwaldem? 5) Ile województw ma Polska? (Vertaling: Beantwoord kort 5 specifieke vragen over Poolse steden, literatuur, bergtoppen, jaartallen en provincies.)
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Uitdrukkingen en idioom - volledige reactie van het model (303 tokens, 42,0 tok/s)
Geteste prompt: Wyjaśnij prostym językiem znaczenie trzech polskich frazeologizmów i do każdego podaj jedno zdanie przykładowe: “wyjść jak Zabłocki na mydle”, “rzucać grochem o ścianę”, “mieć muchy w nosie”. (Vertaling: Leg in eenvoudige bewoordingen de betekenis van drie spreekwoorden uit en geef telkens een voorbeeldzin.)
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Licentie: wat mag je ermee?
Gemma 4 wordt uitgebracht onder de Apache 2.0-licentie. Dat is een flinke stap vooruit ten opzichte van Gemma 3, waar Google nog eigen gebruiksvoorwaarden hanteerde met specifieke restricties. In de praktijk betekent dit:
- je mag het model zonder beperkingen commercieel inzetten, ook binnen klantgerichte producten;
- je mag het model finetunen en aangepaste versies distribueren (met behoud van de licentievermelding);
- er zijn geen licentiekosten verschuldigd aan Google: je betaalt enkel voor je eigen hardware en stroomverbruik.
Stappenplan: Gemma 4 31B lokaal draaien in Ollama
- Installeer Ollama via ollama.com (wij gebruikten versie 0.40.1). Wil je modellen op een secundaire schijf opslaan, stel dan de omgevingsvariabele
OLLAMA_MODELSin (bij onsD:AIollama). Meer hierover lees je in onze Ollama-handleiding. - Download het model (circa 18 GB):
ollama pull gemma4:31b-it-qat
- Verruim de time-out bij tragere opslag. Ollama hanteert standaard een time-out van 5 minuten. Vanaf een externe usb-schijf duurde het inladen bij ons 8 tot 14 minuten, waardoor de eerste poging vastliep op “timed out waiting for llama-server to start”. Sluit Ollama eerst volledig af en start de service in PowerShell met een hogere limiet:
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
De beste remedie blijft echter om zware modellen rechtstreeks op een snelle NVMe-ssd te plaatsen.
- Start het model en controleer de snelheid in een tweede terminalvenster:
ollama run gemma4:31b-it-qat --verbose "Wyjaśnij w 3 zdaniach po polsku, czym jest kwantyzacja QAT."Vertaling van de prompt: “Leg in 3 zinnen in het Pools uit wat QAT-kwantisatie is.” De vlag
--verbosetoont na afloop de “eval rate” in tokens per seconde. De denkmodus zet je desgewenst uit met--think=false. - Controleer de VRAM-toewijzing:
ollama ps
nvidia-smi
In de kolom PROCESSOR moet “100% GPU” staan. Zie je een verdeling over CPU en GPU, verklein dan het contextvenster of sluit andere grafische processen.
- Contextgrootte instellen via de API (zo voerden we de metingen uit de tabel uit):
curl http://127.0.0.1:11434/api/chat -d "{"model":"gemma4:31b-it-qat","messages":[{"role":"user","content":"Cześć"}],"think":false,"options":{"num_ctx":32768}}" - Geheugen weer vrijmaken na gebruik:
ollama stop gemma4:31b-it-qat
Voor wie is Gemma 4 31B lokaal geschikt?
- Aanrader als je beschikt over een videokaart met 24 GB VRAM (zoals een RTX 4090, 3090 of 5090) en maximale taal- en redeneerkwaliteit zoekt zonder data naar de cloud te sturen.
- Aanrader voor het verwerken van vertrouwelijke documenten, proeflezen en samenvatten: 42 tokens per seconde is meer dan snel genoeg.
- Niet geschikt als je kaart 16 GB VRAM of minder heeft: kies dan voor Gemma 4 12B. Die bleek in onze tests al bijzonder sterk en werkt zo’n 2,5 keer sneller.
- Niet geschikt wanneer je op dezelfde grafische kaart tegelijkertijd afbeeldingen of videobeelden wilt genereren.
Een compleet overzicht van lokale opties voor tekst, beeld en video vind je in onze gids over lokale AI. Twijfel je over de hardware-eisen, lees dan ons overzicht over hoeveel VRAM je nodig hebt per modelgrootte.
Veelgestelde vragen
Hoeveel VRAM vereist Gemma 4 31B?
In de QAT-versie (4-bits) reserveert Ollama 19,2 GB bij een context van 8.000 tokens en 19,3 GB bij 32.000 tokens. Omdat het totale VRAM-verbruik van het systeem tijdens piekbelasting opliep tot 24 GB, heb je in de praktijk een videokaart van 24 GB nodig waarop geen andere zware applicaties draaien.
Draait Gemma 4 31B soepel op een RTX 4090?
Ja, het model draait volledig op de GPU met een stabiele snelheid van 40 tot 43 tokens per seconde. Voorwaarde is wel dat geen enkel ander programma beslag legt op het videogeheugen; zodra we ComfyUI op de achtergrond startten, kelderde de snelheid naar 0,5 tot 2,7 tok/s.
Hoe presteert Gemma 4 31B in veeleisende taaltaken?
Het model presteert uitstekend: in onze vijf gevarieerde tests behaalde het 9,5 van de 10 punten, zonder fouten in feitenkennis of factuurberekeningen. Het enige minpuntje was dat het model een lastige achternaam in een e-mailopdracht simpelweg wegliet.
Mag ik Gemma 4 commercieel gebruiken?
Ja, dankzij de Apache 2.0-licentie mag je het model vrij inzetten voor commerciële doeleinden, finetunen en verder verspreiden.
Waarom geeft Ollama een foutmelding bij het inladen van Gemma 4 31B?
De meest voorkomende oorzaak is een trage schijf: Ollama hanteert standaard een time-out van 5 minuten. Verhoog deze limiet met OLLAMA_LOAD_TIMEOUT=30m of verplaats de modelbestanden naar een snelle NVMe-ssd. Een tekort aan vrij VRAM kan eveneens voor fouten zorgen; sluit in dat geval andere GPU-intensieve software af.
Kun je beter kiezen voor Gemma 4 31B of 12B?
Heb je een kaart met 24 GB en staat maximale antwoordkwaliteit voorop, dan is de 31B de betere keuze. Voor kaarten met minder geheugen of wanneer pure snelheid telt, presteert de 12B-variant uitstekend (104 tok/s bij een geheugengebruik van slechts 8 GB in onze tests).
Bronnen en verificatiedatum
- Modelkaart Gemma 4 31B op Hugging Face (licentie, parameters, aanbevolen instellingen).
- Ollama: gemma4-tags.
- Metingen: ons testsysteem (RTX 4090 24 GB, Windows 11, Ollama 0.40.1), 8 oktober 2026.
More on this from HELDER

 benchmarks·Wan 3.0 getest: het nieuwe nummer 1 AI-videomodel van AlibabaWan 3.0 van Alibaba voert de ranglijst aan: 30 seconden video met geluid in één take. We testten de beeldkwaliteit, audio, promptprecisie en kosten.