Qwen-Image-2.1 vs gesloten modellen: 4 tests op RTX 4090
Qwen-Image-2.1 lokaal op een RTX 4090 getest tegen Ideogram 4.5 en FLUX 3: tekstweergave, lay-outcontrole, tien opeenvolgende bewerkingen en detail.
👁 115 keer gelezen
Qwen-Image-2.1 is momenteel het best scorende open beeldmodel op het Artificial Analysis-klassement. Daarom heb ik het model onderworpen aan dezelfde vier praktijktests die ik eerder uitvoerde voor Ideogram 4.5 en FLUX 3. Qwen draaide lokaal op mijn RTX 4090, terwijl de concurrenten via API’s werkten. Het resultaat kent twee kanten: een losse afbeelding oogt fraai en staat binnen 6 tot 20 seconden op je scherm tegen minimale stroomkosten. Bij specifieke tekstweergave, exacte lay-outinstructies en opeenvolgende bewerkingen blijven gesloten modellen echter duidelijk in het voordeel.
De ranglijst van Artificial Analysis is gebaseerd op stemmen van gebruikers die het visueel aantrekkelijkste beeld kiezen. Dat is een prima graadmeter voor esthetiek, maar zegt niets over de vraag of een model foutloze belettering levert, een object precies in een hoek plaatst of bruikbaar blijft na tien opeenvolgende correcties. Daarom meet ik deze aspecten afzonderlijk met vaste evaluatiescripts en dezelfde instructies als bij de commerciële alternatieven.
Hoe er is getest
- Hardware: RTX 4090 (24 GB), ComfyUI, Qwen-Image-2.1 in int8-variant (16,6 GB aan bestanden), 25 stappen, Euler-sampler, cfg 1,0 - conform de officiële instellingen.
- Concurrenten: dezelfde opdrachten via de fal.ai-API, zoals beschreven in de evaluaties van Ideogram 4.5 en FLUX 3 van 1 oktober 2026.
- Eén poging per taak, vaste seed, zonder handmatige selectie achteraf.
- Datum van uitvoering: 2 oktober 2026.
Testresultaten in het kort
| Test | Qwen-Image-2.1 (lokaal) | Beste resultaat in de testgroep |
|---|---|---|
| Tekstweergave (13 te reproduceren termen, getest in het Pools) | 6/13 | 13/13 - GPT Image 2.5, Nano Banana Pro, Nano Banana 2, Grok |
| Objectplaatsing op doellocatie (16 doelen) | 2/16, IoU 0,17 | 16/16, IoU 0,89 - FLUX 3 met JSON-kaders |
| Detailweergave in breed kader | 2752 × 1536, effectief 3,1 Mpx | 16,8 Mpx - FLUX 3 in 4K |
| Leesbare kleine uithangborden (8) | 2/8 | 8/8 - GPT Image 2.5, Grok, Seedream |
| 10 bewerkingen achter elkaar (SSIM na stap 10) | 0,11 | 0,95 - Ideogram 4.5 |
| Generatietijd per beeld (1024 × 1024) | ca. 6 s | concurrenten via API: 20-60 s |
| Kosten per beeld | stroomverbruik (fractie van een eurocent) | ca. € 0,021 tot € 0,20 (0,024-0,22 USD via API; omgerekend volgens ECB-referentiekoers van 12-10-2026 via ecb.europa.eu) |
Test 1: tekstweergave (getest in het Pools)
Vier opdrachten: een uitverkoopposter, een menukaart voor een traditionele eetgelegenheid, een boekomslag (Nederlandse vertaling van het Poolse origineel: “Grashalm en gal”) en een verpakking voor pierogi. In totaal moesten 13 tekstfragmenten letterlijk correct worden overgenomen. De prompts en belettering zijn in het Pools getest om de omgang met complexe diakritische tekens te beoordelen. De automatische OCR-uitlezing heb ik op elk beeld handmatig nagelopen. Bij de menukaart is één onterechte OCR-fout gecorrigeerd (Nederlandse vertaling van het Poolse origineel: “DAGMENU” stond er feitelijk correct op).
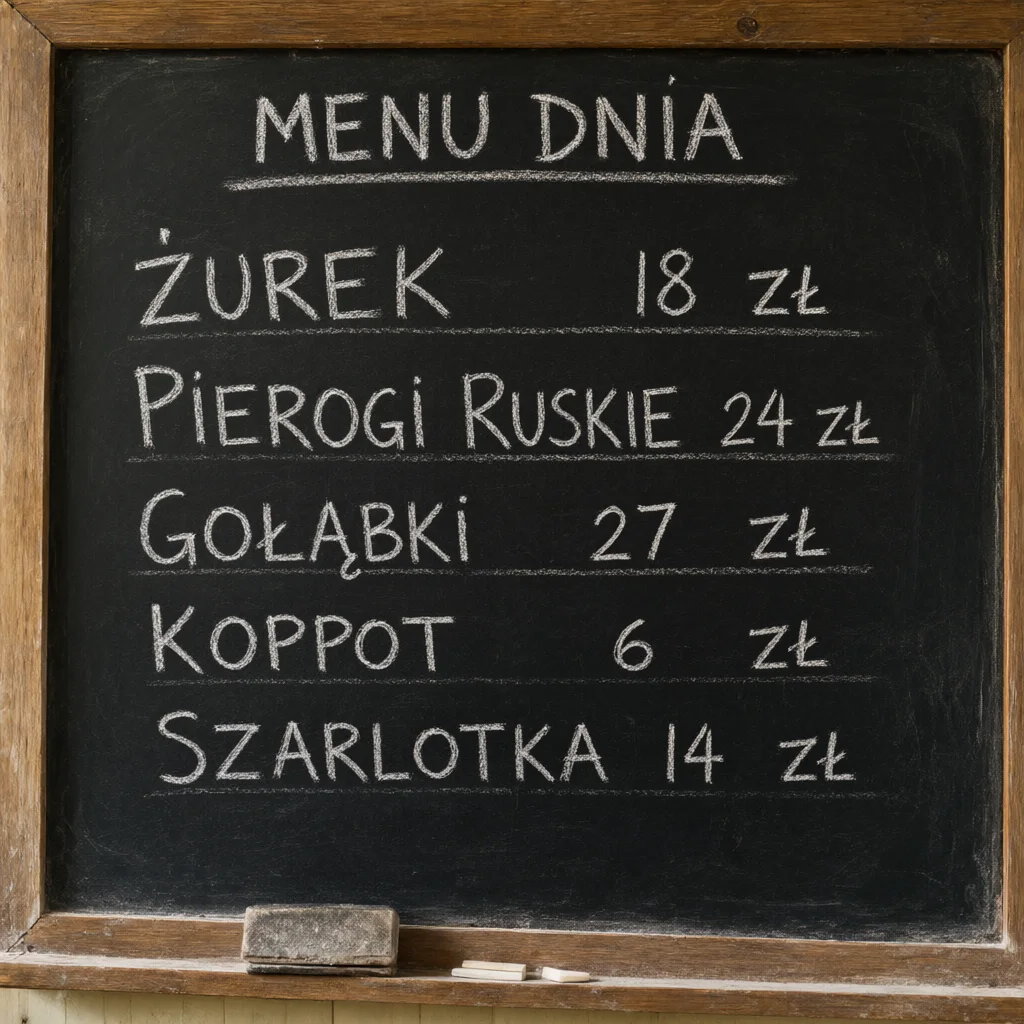
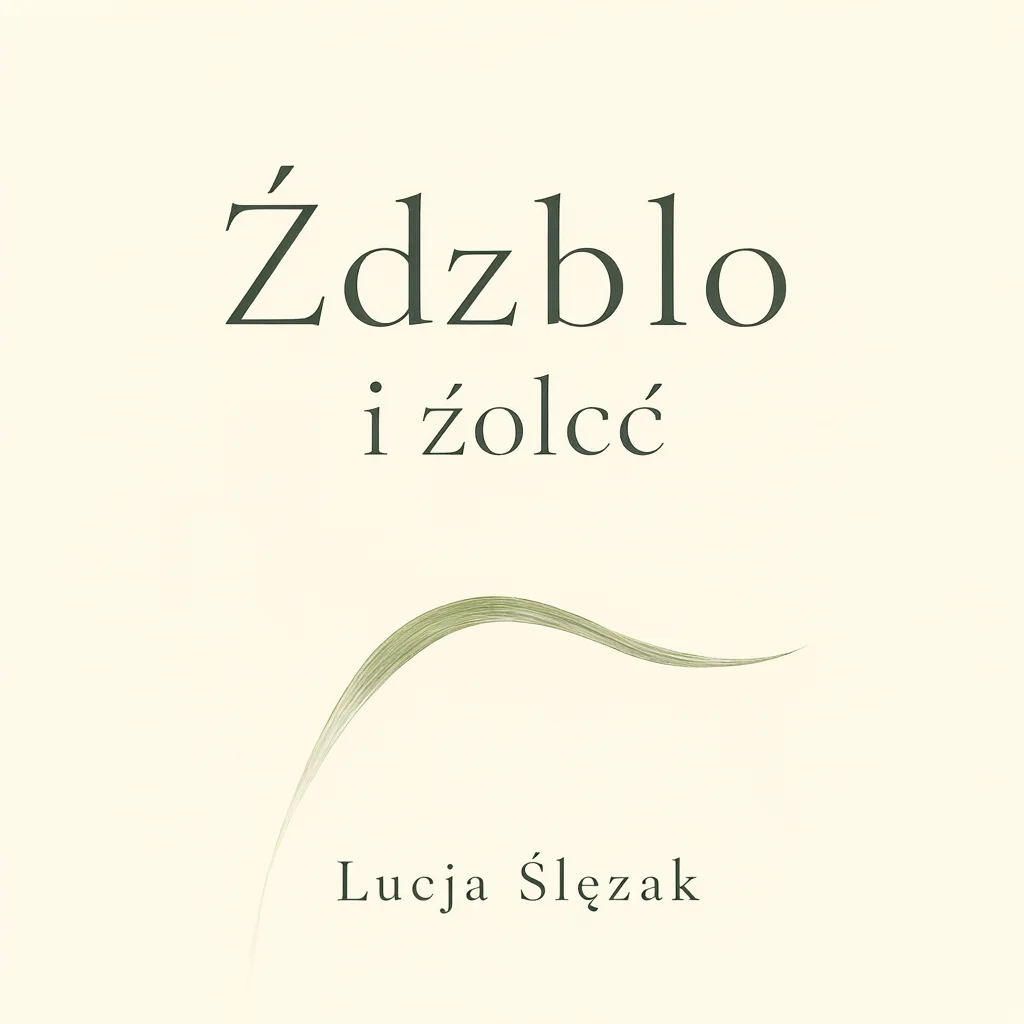
Grote, opvallende woorden met gangbare speciale tekens lukken prima: Nederlandse vertaling van de Poolse originelen: “ZURE ROGGESOEP”, “GEVULDE KOOLBLADEREN”, “UITVERKOOP”. De problemen ontstaan bij minder alledaagse lettercombinaties en kleine corpsgroottes. Op de knoedeldoos verscheen verminkte belettering in de oorspronkelijke Poolse test en verminkte belettering in de oorspronkelijke Poolse test, en op de poster stond verminkte belettering in de oorspronkelijke Poolse test. Voor grafische uitingen met veeleisende tekst is het model zonder handmatige correcties nog niet betrouwbaar.
Test 2: objecten op specifieke coördinaten
Vier scènes met elk vier objecten, waarbij elk element een nauwkeurig gedefinieerde locatie kreeg uitgedrukt in percentages van de breedte en hoogte van het kader. Qwen-Image-2.1 ondersteunt geen gestructureerd kaderformaat; het model ontving daarom dezelfde tekstuele beschrijving als Nano Banana Pro, GPT Image 2.5 en Seedream. Een computervisieweergavemodel bepaalde de uiteindelijke posities, waarna de overlap met het doelvak werd berekend (Intersection over Union, IoU).
| Model | Gemiddelde IoU | Objecten correct geplaatst |
|---|---|---|
| FLUX 3 Image (JSON-kaders) | 0,89 | 16/16 |
| Seedream 5.0 Pro | 0,79 | 15/16 |
| GPT Image 2.5 Sunburst | 0,54 | 11/16 |
| Nano Banana Pro | 0,48 | 7/16 |
| Ideogram 4.5 | 0,37 | 7/16 |
| Qwen Image 3 (API) | 0,35 | 6/16 |
| Qwen-Image-2.1 (lokaal) | 0,17 | 2/16 |
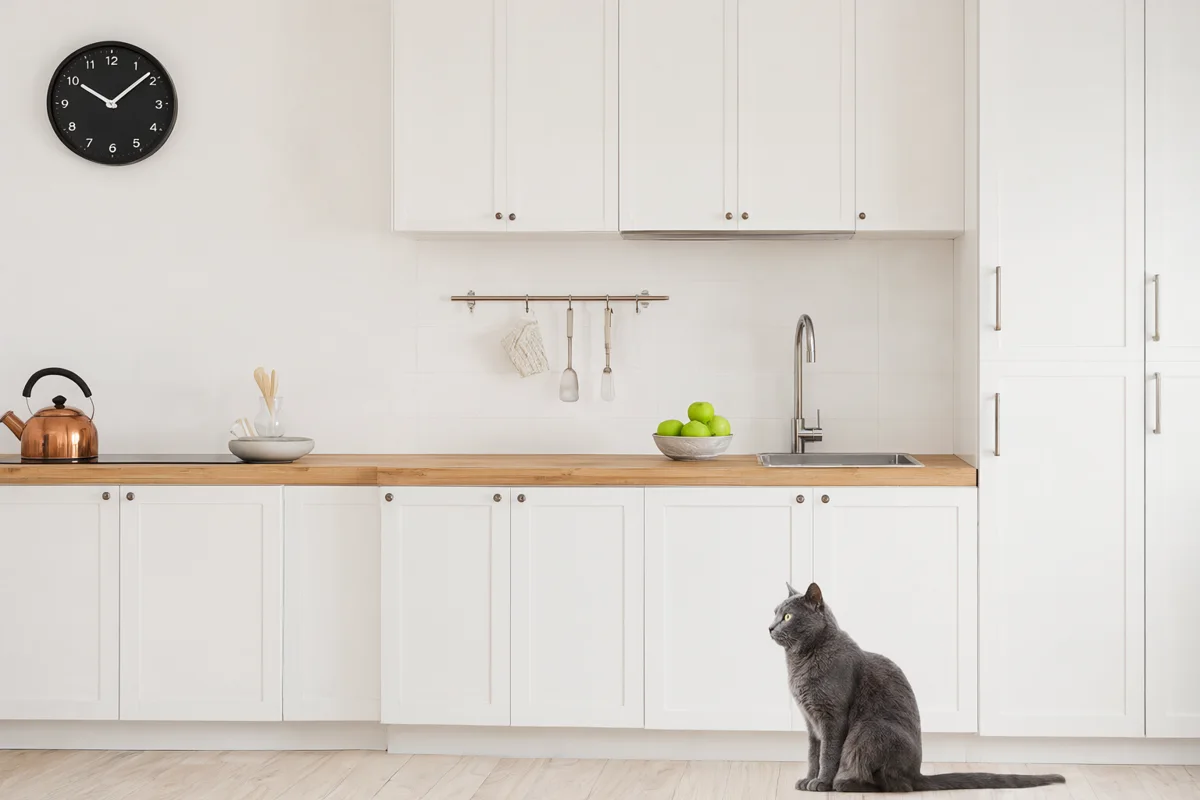
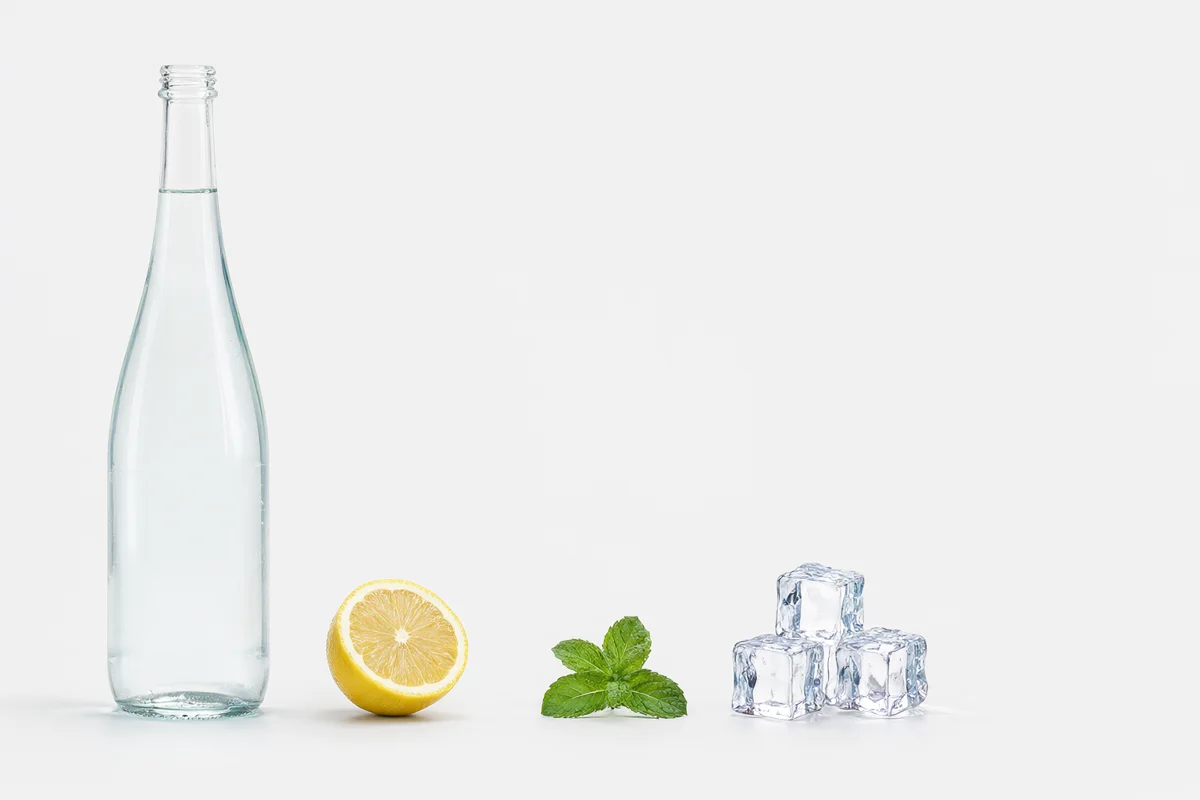
De gegenereerde beelden ogen verzorgd en bevatten alle gevraagde elementen. Het model kiest echter zelf een compositie en beschouwt de percentuele opgaven eerder als een vrijblijvende suggestie. Als je ontwerp vaste uitsparingen vereist voor een merknaam of typografie, ben je beter af met FLUX 3 (via JSON-kaders) of Seedream.
Test 3: detailweergave in breed kader
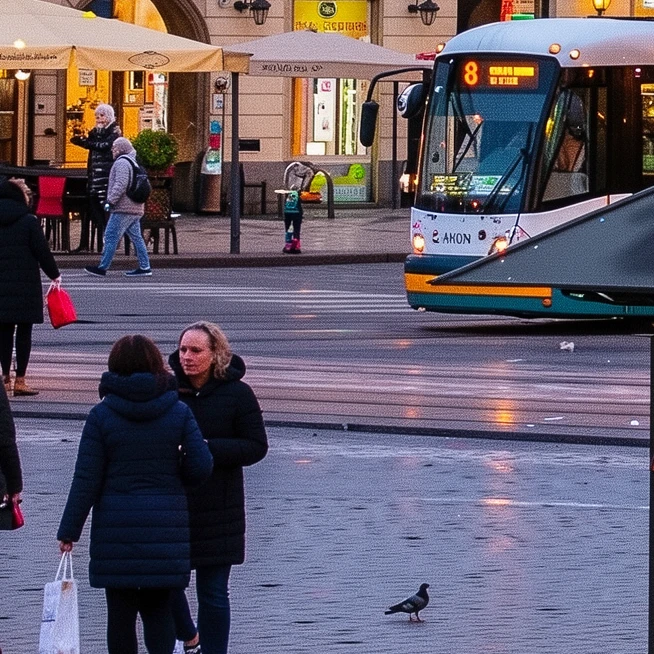
Hetzelfde overzicht van het centrale marktplein in Krakau met zes uithangborden, een kiosk en een tram. Qwen-Image-2.1 genereerde het tafereel in zijn maximale 16:9-resolutie van 2752 × 1536 pixels in 49 seconden. De effectieve resolutie bedraagt ongeveer 3,1 Mpx aan echte details, vergelijkbaar met Grok Imagine 2 (3,3 Mpx). Slechts 2 van de 8 uithangborden bleven leesbaar: “KWIATY” en de kiosk-koptekst “MIASTO BEZ KORKÓW?”. Kleinere letters vervielen tot onscherpe vlekken.
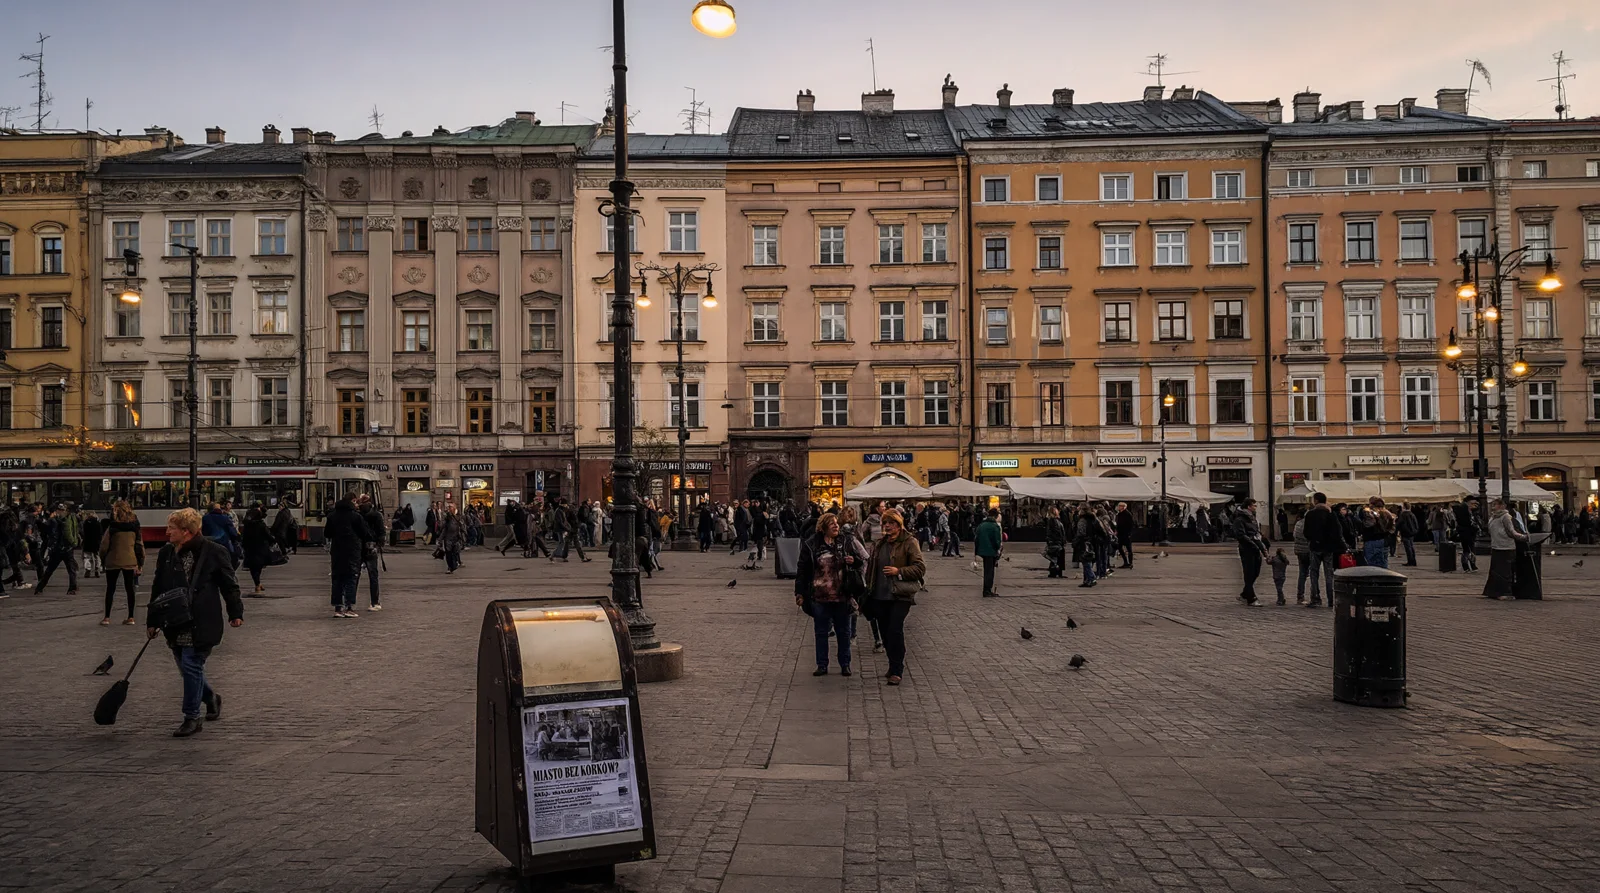
Test 4: 10 opeenvolgende bewerkingen
Vertrekkend van een foto van een bakkerij werden tien sequentiële aanpassingen uitgevoerd: een andere deur, een sticker, een step in plaats van een fiets, de auto weg, een ander uithangbord, lavendel toevoegen, een jas aanpassen, een kat erbij, een prijsbord wijzigen en de vuilnisbak verwijderen. Elke stap nam het resultaat van de vorige als invoer. Ik heb gemeten hoeveel beeldkwaliteit behouden bleef in de zones die onaangeroerd moesten blijven (SSIM, waarbij 1 staat voor identiek).
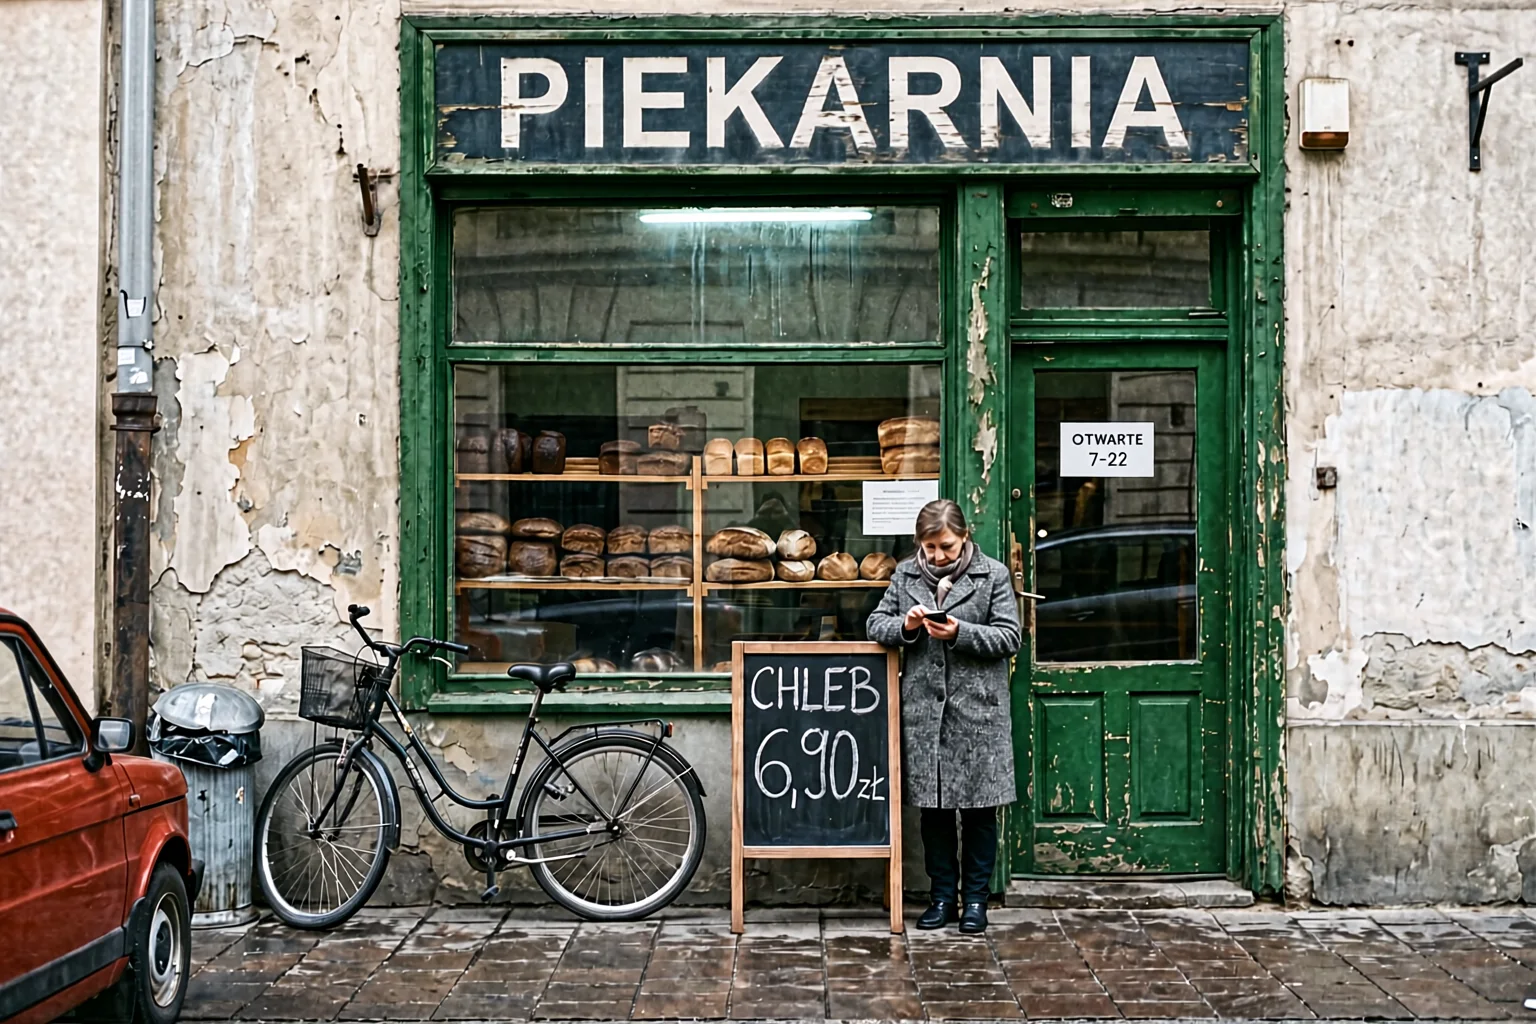
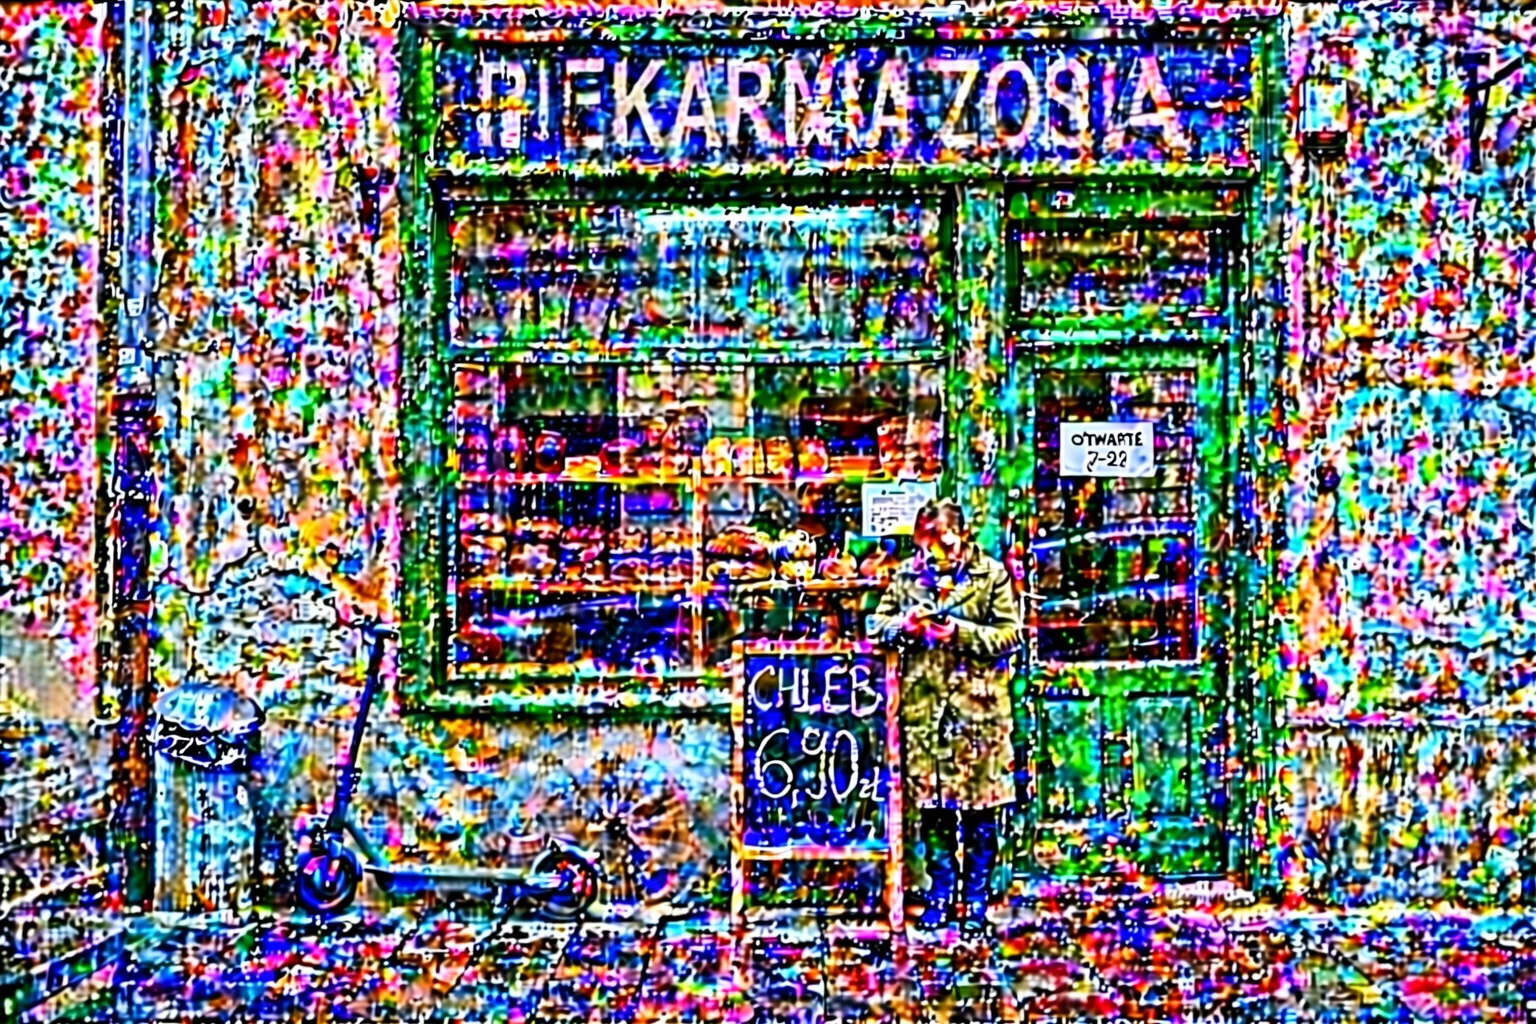
De gevraagde aanpassingen voert Qwen-Image-2.1 inhoudelijk goed uit: de deur werd groen, de fiets veranderde in een step, de auto verdween en op het bord verscheen de gevraagde tekst (Nederlandse vertaling van het Poolse origineel: “BAKKERIJ ZOSIA”). Elke tussenstap voegt echter ruis toe en verzadigt de tinten verder. Na drie bewerkingen worden artefacten storend zichtbaar; na stap zes is het bestand onbruikbaar. Een enkele bewerkingsslag ziet er daarentegen prima uit, wat aansluit bij de 18e plek van het model in de Artificial Analysis-bewerkingsranglijst. Die lijst toetst echter uitsluitend een enkele ingreep, geen keten van tien.
Een belangrijke kanttekening: deze meting betrof de int8-versie in ComfyUI. Bij een initiële poging waarbij de referentie-invoer op 1024 px stond tegenover een uitvoer van 2048 px, stapelde de ruis zich nog sneller op (SSIM 0,08). Gelijkgestelde resoluties verbeterden het resultaat, maar losten het onderliggende degradatieprobleem niet op. Mogelijk presteert de volledige bf16-versie of een andere samplerafstelling schoner; bf16 kon echter niet getest worden omdat die variant samen met de tekstencoder niet binnen 24 GB videogeheugen past.
Praktische tip: wanneer je meerdere wijzigingen nodig hebt, pas dan telkens het originele basisbeeld aan via één gecombineerde instructie, in plaats van correctie op correctie te stapelen.
Conclusies en aanbevelingen
- Voor snelle, esthetische beelden zonder tekst: Qwen-Image-2.1 presteert uitstekend met 6 seconden per 1K-afbeelding, geen lopende API-kosten en sterke scores in blinde voorkeurstests.
- Voor afbeeldingen met complexe tekst: geef de voorkeur aan GPT Image 2.5 of Nano Banana Pro.
- Voor ontwerpen met een strikte lay-out: kies voor FLUX 3 met JSON-kaders.
- Voor meervoudige correctierondes op één afbeelding: Ideogram 4.5 of FLUX 3 leveren aanzienlijk stabielere resultaten.
- Let op de licentievoorwaarden: de Qwen Research-licentie staat uitsluitend onderzoeks- en evaluatiedoeleinden toe. Commercieel gebruik vereist een aparte overeenkomst met Alibaba; zie de toelichting over de licentie.
Een volledig overzicht van open alternatieven vind je in de ranglijst van open beeldmodellen. De specifieke positie van Qwen-Image-2.1 binnen de Artificial Analysis-ranglijst bespreek ik in een afzonderlijk nieuwsbericht.
Google · Jouw bronnenHoger in Google - met één klikToevoegen aan voorkeursbronnen →Veelgestelde vragen
Presteert Qwen-Image-2.1 beter dan Nano Banana Pro?
In de blinde vergelijkingstests van Artificial Analysis niet: Nano Banana Pro behaalt 1101 punten tegenover 1034 voor Qwen-Image-2.1. In mijn eigen tests scoorde Nano Banana Pro overtuigend beter op tekstweergave (13 tegen 6) en positienauwkeurigheid. Qwen scoort daarentegen op operationele kosten en de mogelijkheid om volledig offline te draaien.
Wat is de rekentijd per beeld op een RTX 4090?
In mijn metingen bedroeg dit circa 6 seconden bij 1024 × 1024 pixels, 10 seconden bij 1536 × 1024, 44 seconden bij 2048 × 2048 en 49 seconden bij 2752 × 1536. Een bewerkingsstap op 1536 × 1024 vergde ongeveer 20 seconden. Let op: de eerste generatie direct na het inladen van het model duurt merkbaar langer.
Waarom holt de kwaliteit achteruit bij meerdere bewerkingen achter elkaar?
Elke bewerkingsstap decodeert en hercodeert de gehele pixelstructuur, waardoor minieme afwijkingen zich cumuleren. Modellen zoals Ideogram 4.5 en FLUX 3 beschikken over mechanismen om ongewijzigde zones rechtstreeks uit het bronbestand te behouden. Qwen-Image-2.1 binnen ComfyUI mist standaard zo’n functionaliteit.
Mag je Qwen-Image-2.1 zakelijk inzetten?
Niet zonder aanvullende licentieovereenkomst. De Research-licentie van het model dekt uitsluitend evaluatie en academisch onderzoek.
- Artificial Analysis - tekst-naar-beeld-ranglijst
- Artificial Analysis - bewerkingsranglijst
- Hugging Face - Qwen-Image-2.1
- Eigen benchmarks van 1 en 2 oktober 2026: testscripts, beelden en metingen (OCR, IoU, SSIM, effectieve resolutie)
More on this from HELDER