Qwen-Image-2.1 ranking: 29 beeldmodellen vergeleken met cijfers
De maker publiceerde een grafiek met 29 beeldmodellen. We lazen de cijfers af en zetten ze naast de modelgroottes - een 7B model verslaat er een van 80B.
👁 117 keer gelezen
De maker van Qwen-Image-2.1 publiceerde bij de lancering een grafiek waarin 29 beeldmodellen worden vergeleken - zowel open als gesloten. Niemand gaf het in tabelvorm, dus lazen we de cijfers af en zetten ze naast de modelgroottes. Het resultaat is interessanter dan alleen de positie in de ranking.
Conclusie in één alinea
Qwen-Image-2.1 staat op de zevende plaats met een score van 60,28 punten in de Qwen-Image-Bench ranking. Ervoor staan uitsluitend gesloten modellen waarvan de makers de grootte niet onthullen. Interessanter is wat erachter gebeurt: het verslaat Nano Banana 2.0, GPT Image 1.5, Seedream 5 Pro en Nano Banana Pro, maar ook FLUX 2 Max dat vier keer zo groot is, en Hunyuan Image 3.0 - elf keer zo groot. Dit is een model van 7 miljard parameters dat een model van tachtig miljard met meer dan negen punten verslaat.
Volledige Qwen-Image-Bench ranking
Cijfers afgelezen van de grafiek die door de maker is gepubliceerd. De kolom met grootte is leeg waar de maker van het model deze niet onthult - op de grafiek aangegeven met een hangslot.
| # | Model | Score | Grootte |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67,01 | niet onthuld |
| 2 | GPT Image 2 | 64,69 | niet onthuld |
| 3 | Grok Imagine 2.0 | 63,47 | niet onthuld |
| 4 | Qwen Image 3 Pro | 62,36 | niet onthuld |
| 5 | Muse Image | 62,34 | niet onthuld |
| 6 | MAI Image 2.5 Pro | 61,02 | niet onthuld |
| 7 | Qwen-Image-2.1 | 60,28 | 7B |
| 8 | Nano Banana 2.0 | 59,82 | niet onthuld |
| 9 | GPT Image 1.5 | 59,65 | niet onthuld |
| 10 | Seedream 5 Pro | 59,53 | niet onthuld |
| 11 | Nano Banana Pro | 59,45 | niet onthuld |
| 12 | Grok Imagine Quality | 58,47 | niet onthuld |
| 13 | Qwen Image 2.0 Pro | 57,84 | niet onthuld |
| 14 | Seedream 5.0 | 57,22 | niet onthuld |
| 15 | Seedream 4.5 | 56,78 | niet onthuld |
| 16 | Seedream 4.0 | 56,21 | niet onthuld |
| 17 | FLUX 2 Max | 55,33 | 32B |
| 18 | FLUX 2 Pro | 54,57 | 32B |
| 19 | GPT Image 1 | 54,07 | niet onthuld |
| 20 | Qwen Image 2512 | 52,06 | 20B |
| 21 | Imagen 4.0 Ultra | 51,99 | niet onthuld |
| 22 | Boogu | 51,40 | 10B |
| 23 | Hunyuan Image 3.0 | 50,81 | 80B |
| 24 | Imagen 4.0 | 50,29 | niet onthuld |
| 25 | Qwen Image | 49,23 | 20B |
| 26 | Kling Image 2.1 | 48,26 | niet onthuld |
| 27 | GLM Image | 48,19 | 16B |
| 28 | LongCat | 46,34 | 6B |
| 29 | HiDream O1 | 46,17 | circa 8B |
Een voorbehoud dat we duidelijk moeten maken: dit is een benchmark gepubliceerd door de maker van een van de beoordeelde modellen. Behandel het als materiaal van de maker, want dat is het. Dat betekent niet dat de cijfers verzonnen zijn - het betekent dat de set taken en de manier van scoren gekozen zijn door een partij die belang heeft bij het resultaat.
Drie dingen die je pas ziet na vergelijking met grootte
1. Sprong binnen de eigen familie
| Versie | Grootte | Score |
|---|---|---|
| Qwen Image | 20B | 49,23 |
| Qwen Image 2512 | 20B | 52,06 |
| Qwen-Image-2.1 | 7B | 60,28 |
Een bijna drie keer kleiner model krijgt 8,22 punten meer dan de directe voorganger. Dit is geen gewone update, maar een andere architectuur - single-stream lagen, gemengde granulariteit van aandacht en hergebruik van key-value cache.
2. Grootte is geen toegangsbewijs meer tot de top
Hunyuan Image 3.0 heeft 80 miljard parameters en een score van 50,81. Qwen-Image-2.1 heeft 7 miljard en 60,28. Het verschil is een factor elf in grootte in het voordeel van de verliezer.
Praktische consequentie voor iemand die hardware berekent: het model dat een betere score geeft, past op één consumentenkaart, terwijl die grotere een serverruimte vereist. Dit is een mening: voor de meeste toepassingen sluit dit de discussie over welke je moet kiezen.
3. Gesloten modellen leiden nog steeds, maar de voorsprong is geslonken
Tot de leider ontbreken 6,73 punten, tot de derde plaats 3,19. Een open model dat je thuis kunt draaien, zit vandaag vijf punten achter de top, niet twintig. Daarachter zijn echter modellen gebleven waarvoor je per afbeelding betaalt.
Wat het model in deze versie kreeg
De maker noemt vier veranderingen:
- Compacte architectuur - 32 DiT-lagen, gemengde granulariteit van aandacht, hergebruik van key-value cache bij meerdere invoerbeelden.
- Native transparantie - mogelijkheid om in de prompt aan te geven dat de afbeelding een alfakanaal moet hebben, en objecten uit foto’s uitsnijden als lagen. We hebben dit gemeten.
- Bewerking - tot tien referentiebeelden, bewerkingsplaats aangeven met een cirkel, overschildering of masker, behoud van identiteit van personen en uiterlijk van producten.
- Texturen en typografie - beter licht op portretten en lay-out van tekst rekening houdend met lettertype en compositie.
Daarnaast panorama’s van één foto, infographics en storyboards met karakterbladen.
Hoe we het zelf hebben getest
We hebben het model lokaal opgezet op een RTX 4090 en zes tests uitgevoerd. Twee conclusies die niet in het materiaal van de maker staan:
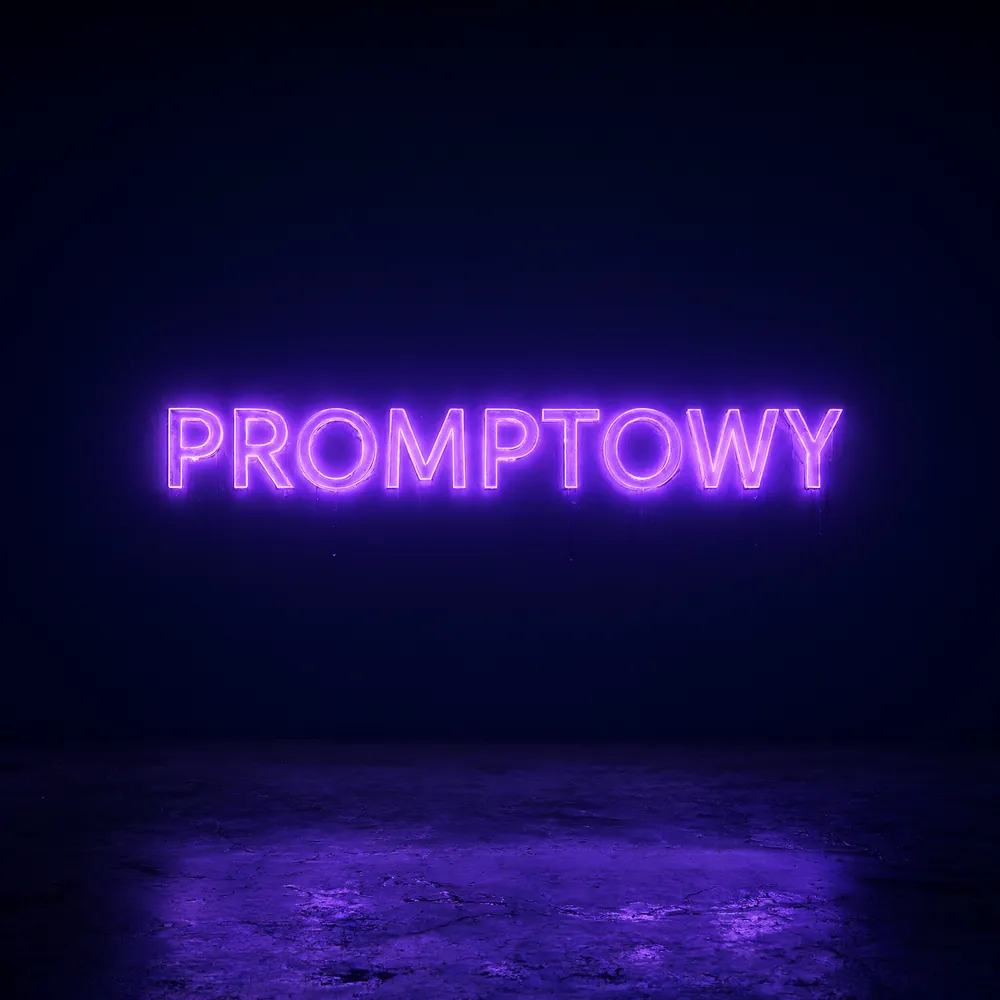
Neon met de tekst [MERK] lokaal gegenereerd in resolutie 2048×2048 - de tekst kwam foutloos in één keer.
- Teksten kloppen inderdaad. Een neon met de tekst [MERK] in 2048×2048 kwam foutloos in één keer.
- Prompts over leeftijd van personages worden soms genegeerd. Een verzoek om een portret van een vrouw van begin dertig gaf een duidelijk oudere persoon - technisch uitstekend, maar niet volgens de prompt.
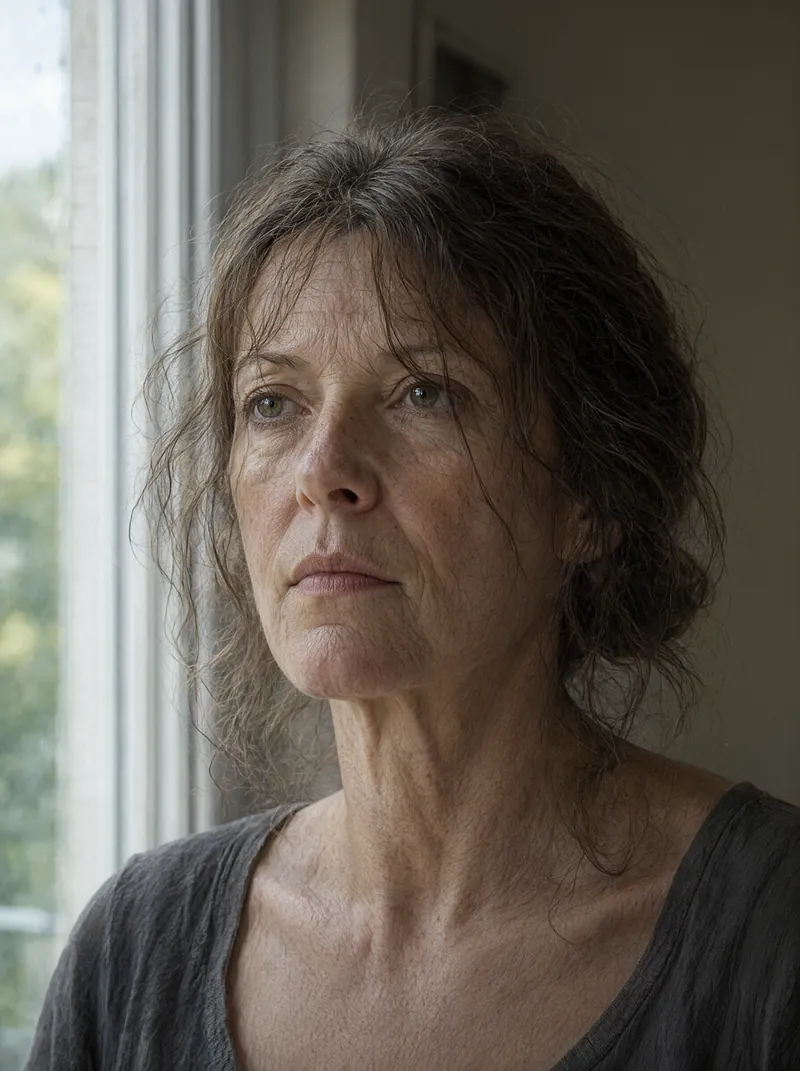
Portret van een prompt over een vrouw van begin dertig. Huidtextuur en licht zonder fouten, leeftijd van het personage duidelijk hoger dan besteld.
Tijden, instellingen en een kant-en-klaar script staan in de installatie-instructies, en we hebben alles verzameld in de gids voor het model.
Hoe de resultaten er in de praktijk uitzien
Een ranking is één getal. Hieronder drie frames uit drie verschillende categorieën, zodat je kunt zien wat achter dat getal zit.
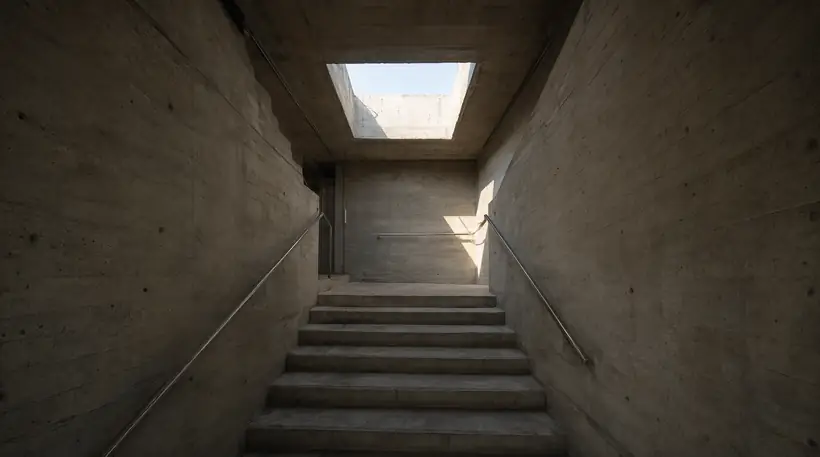
Architectuur - de categorie waarin het model het sterkst presteert.
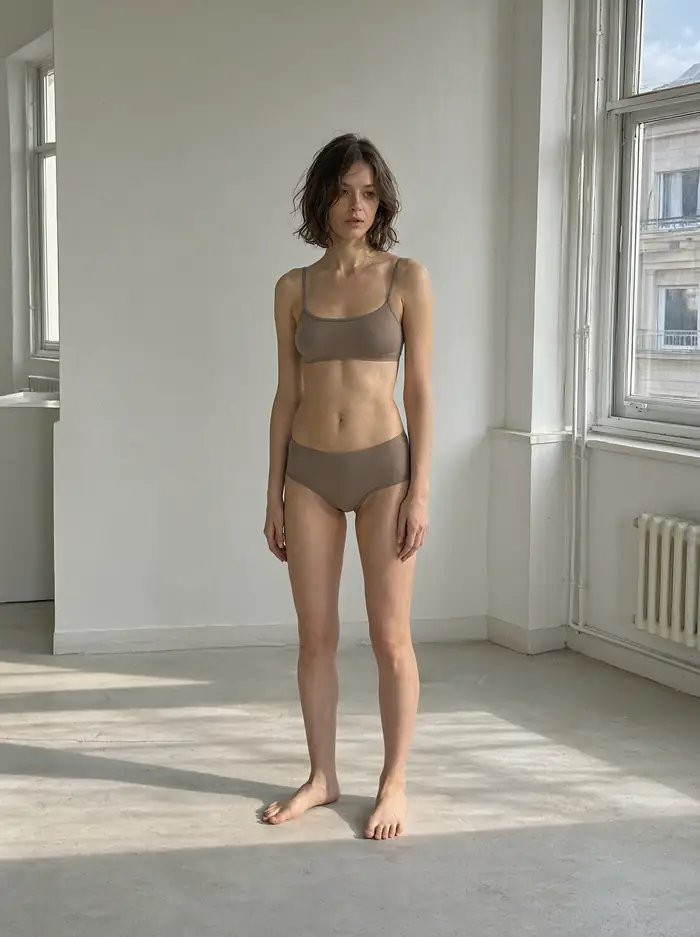
Beschikbaar licht - het model kiest voor een reportage-uitstraling in plaats van een campagne-look.
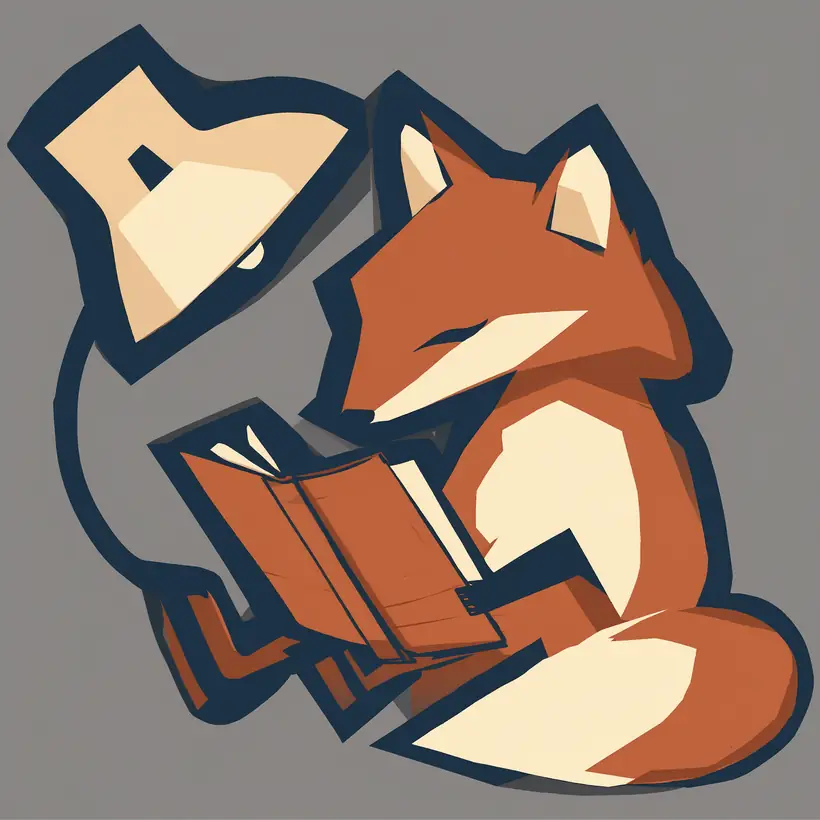
Vectorillustratie - correct, maar generiek. Hier zie je de grens.
Veelgestelde vragen
Welke score heeft Qwen-Image-2.1 in de benchmark?
60,28 punten in Qwen-Image-Bench, zevende plaats onder 29 vergeleken modellen.
Is dit het beste open beeldmodel?
In deze vergelijking wel - het verslaat FLUX 2 Max (55,33), Hunyuan Image 3.0 (50,81) en GLM Image (48,19). Onthoud dat de ranking van de maker komt.
Hoeveel parameters heeft het?
7 miljard in het beeldgenererende deel, in 32 single-stream DiT-lagen.
Welk model wint de ranking?
GPT Image 2.5 Sunburst met een score van 67,01, voor GPT Image 2 (64,69) en Grok Imagine 2.0 (63,47).
Is het beter dan Nano Banana?
Volgens deze ranking wel: 60,28 tegenover 59,82 voor Nano Banana 2.0 en 59,45 voor Nano Banana Pro. Het verschil is echter klein.
Bronnen en controledatum
- Resultaten afgelezen op 22 september 2026 van de Qwen-Image-Bench grafiek gepubliceerd in de aankondiging op qwen.ai
- beschrijving van architectuur en functies uit dezelfde aankondiging en van de modelkaart Qwen/Qwen-Image-2.1. De maker gaf deze gegevens in de vorm van een grafiek
- geen tabel - de cijfers in bovenstaande tabel zijn door de redactie afgelezen van die grafiek. Observaties over teksten en leeftijd van personages komen uit onze eigen tests op RTX 4090
More on this from HELDER

 benchmarks·Qwen-Image-2.1 ‘zonder censuur’: wat de officiële weights doenBij de release van Qwen-Image-2.1 verschenen tientallen 'uncensored' versies. We testten de officiële weights - en ontdekten dat er helemaal geen filter zit.