categorie · 166 artikelen · laatste 9.11.2026 · pagina 5
Benchmarks
 benchmarks·Claude Opus 5 en 5 andere AI-modellen getest op biologievragenAnthropic verscherpte de beveiliging voor dual-use vragen. We testten zes modellen met acht biologievragen.
 benchmarks·Schaal voor zekerheid AI-model: 0-20 werkt beter dan 0-100
 benchmarks·Agent AI slaagt één keer. Lukt het ook de tweede keer?IBM Research toont aan dat AI-agents veel minder betrouwbaar zijn dan benchmarks doen geloven.
 benchmarks·AI-modellen test 16.09.2026: 7 modellen, 4 taken, volledige resultatenZeven AI-modellen getest op identieke taken: tekstredactie, tabel-extractie, code en contextvenster.
 benchmarks·Vijf valkuilen van SEO-tools die je vraag verkeerd beantwoorden
 benchmarks·121 Core Web Vitals metingen: mijn beste hypotheses faaldenCSS samenvoegen verslechterde TBT van 76 naar 372 ms. AJAX uitstellen van 64 naar 265 ms.
 benchmarks·AI-model weigert documenten te lezen: test bij drie providersContexttest toonde content_filter bij elk document boven ~2000 tokens op AWS, bij de maker en in Google.
 benchmarks·Grok 4.7 vs Fable 5.1 vs GPT-5.6 Sol: kosten per puntFable wint 4 van de 7 benchmarks, maar kost 8× meer op output.
 benchmarks·Transparante PNG uit Qwen-Image-2.1: alfakanaal getest
 benchmarks·Qwen-Image-2.1 ranking: 29 beeldmodellen vergeleken met cijfersDe maker publiceerde een grafiek met 29 beeldmodellen.
 benchmarks·Qwen-Image-2.1 ‘zonder censuur’: wat de officiële weights doenBij de release van Qwen-Image-2.1 verschenen tientallen 'uncensored' versies.
 benchmarks·Qwen-Image-2.1 posters: 8 stijlen, 1 conclusieWe bestelden dezelfde poster in acht grafische stijlen. Zeven van de acht hebben een correcte titel.
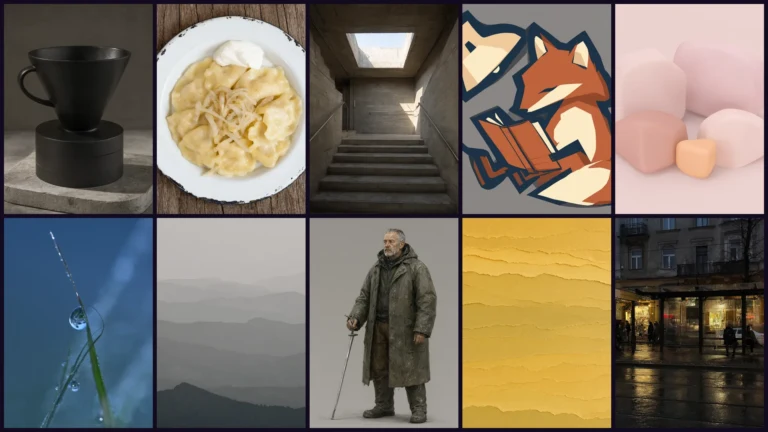 benchmarks·Wat kan Qwen-Image-2.1: tien beelden uit tien wereldenVan productfoto tot vectorillustratie.
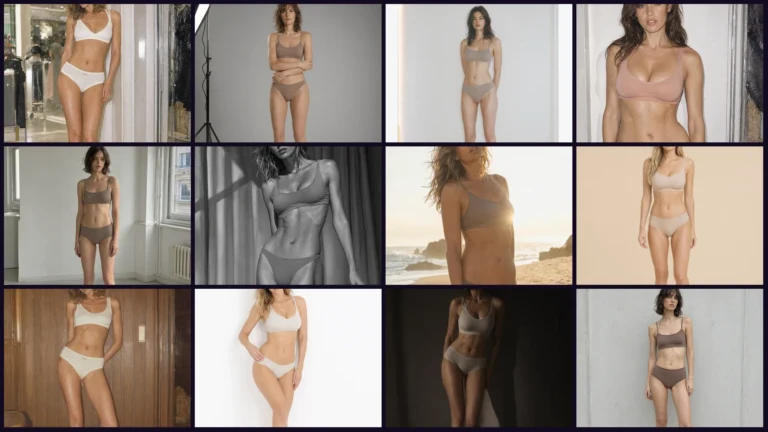 benchmarks·Qwen-Image-2.1 modefotografie: twaalf fotografische stijlen35mm film, middenformaat, polaroid, jaren 90 flitser, high key en low key.
 benchmarks·Xiaomi MiMo-V2.6: krachtigste open AI-model - prijs en benchmarks
 benchmarks·Waarom CSS-bestanden samenvoegen je site trager maaktEen 69 KB CSS-bundle verhoogde TBT van 76 naar 372 ms.
 benchmarks·Claude Opus 5.5 benchmarks: volledige tabel en voetnotenTerminal-Bench 66,4%, GDPval-AA 1846 Elo, OSWorld 81,8%.
 benchmarks·Claude Opus 5.5 vs Fable 5.1: wanneer betaal je 2,5x meer?
 benchmarks·Verzint Claude Opus 5.5 cijfers? Test met valstrik voor directieNotitie zonder winst, marge en verloop, maar de directie vraagt alle drie.
 benchmarks·Claude Opus 5.5 effort levels: low, medium of high - verschil gemetenDe standaard effort is van high naar medium gegaan.
 benchmarks·GPT-6 Luna: goedkoopste OpenAI-model haalt mijn tests voor 0,0024 USDGPT-6 Luna kost 0,10/0,50 USD per miljoen tokens.
 benchmarks·AI Act kennis chatbots: 8 van 9 modellen geven foute data
 benchmarks·LLM’s begrijpen niet hoe code werkt tijdens uitvoering - SWE-FluxTaalmodellen schrijven code, maar begrijpen ze wat er gebeurt als die code draait?
 benchmarks·Midjourney vs Gemini: welke AI-beeldgenerator wint in 2026?
 benchmarks·AI beeldgeneratoren vergelijking: 8 modellen getest
 benchmarks·ElevenLabs Agents test: Nederlandse tandartslijn met voicebot