AI-beslissingsmodellen: Decision Index vergeleken
Wat is een AI-beslissingsmodel? Een vergelijking tussen Cloudflare Clef, Amazon Strands Decider en LLM's, inclusief hardware-eisen en praktijktest.
👁 132 keer gelezen
Een beslissingsmodel (decision model) is een AI-model dat zelf geen tekst formuleert, maar een antwoord kiest uit een door jou aangeleverde lijst en daarbij aangeeft hoe zeker het is. In plaats van een zin als “deze melding gaat waarschijnlijk over een betaling” ontvang je direct betalingen: 0,97. Jouw code bepaalt vervolgens direct de logische vervolgstap. Op 1 oktober 2026 bracht Cloudflare de open modellen Clef en Clef-flash uit, terwijl AWS diezelfde dag Strands Decider 2B lanceerde. Beide zijn lokaal getest op een RTX 4090 aan de hand van 30 praktijkcases (oorspronkelijk opgesteld in het Pools).
Artificial Analysis Decision Index: de eerste onafhankelijke ranglijst van beslissingsmodellen (13 oktober 2026)
Een beslissingsmodel schrijft geen tekst. Het ontvangt een gestructureerde vraag - kies één optie, ja of nee, een score - en retourneert in één enkele aanroep een waarschijnlijkheid voor elke toegestane optie. Op 13 oktober 2026 publiceerde Artificial Analysis (AA) de Decision Index v1.0, waarin 11 van dergelijke modellen met elkaar en met reguliere LLM’s worden vergeleken die dezelfde taken uitvoeren via gestructureerde outputs. Alle onderstaande cijfers zijn afkomstig van het AA-leaderboard van 13 oktober 2026; de live tabel kan veranderen.
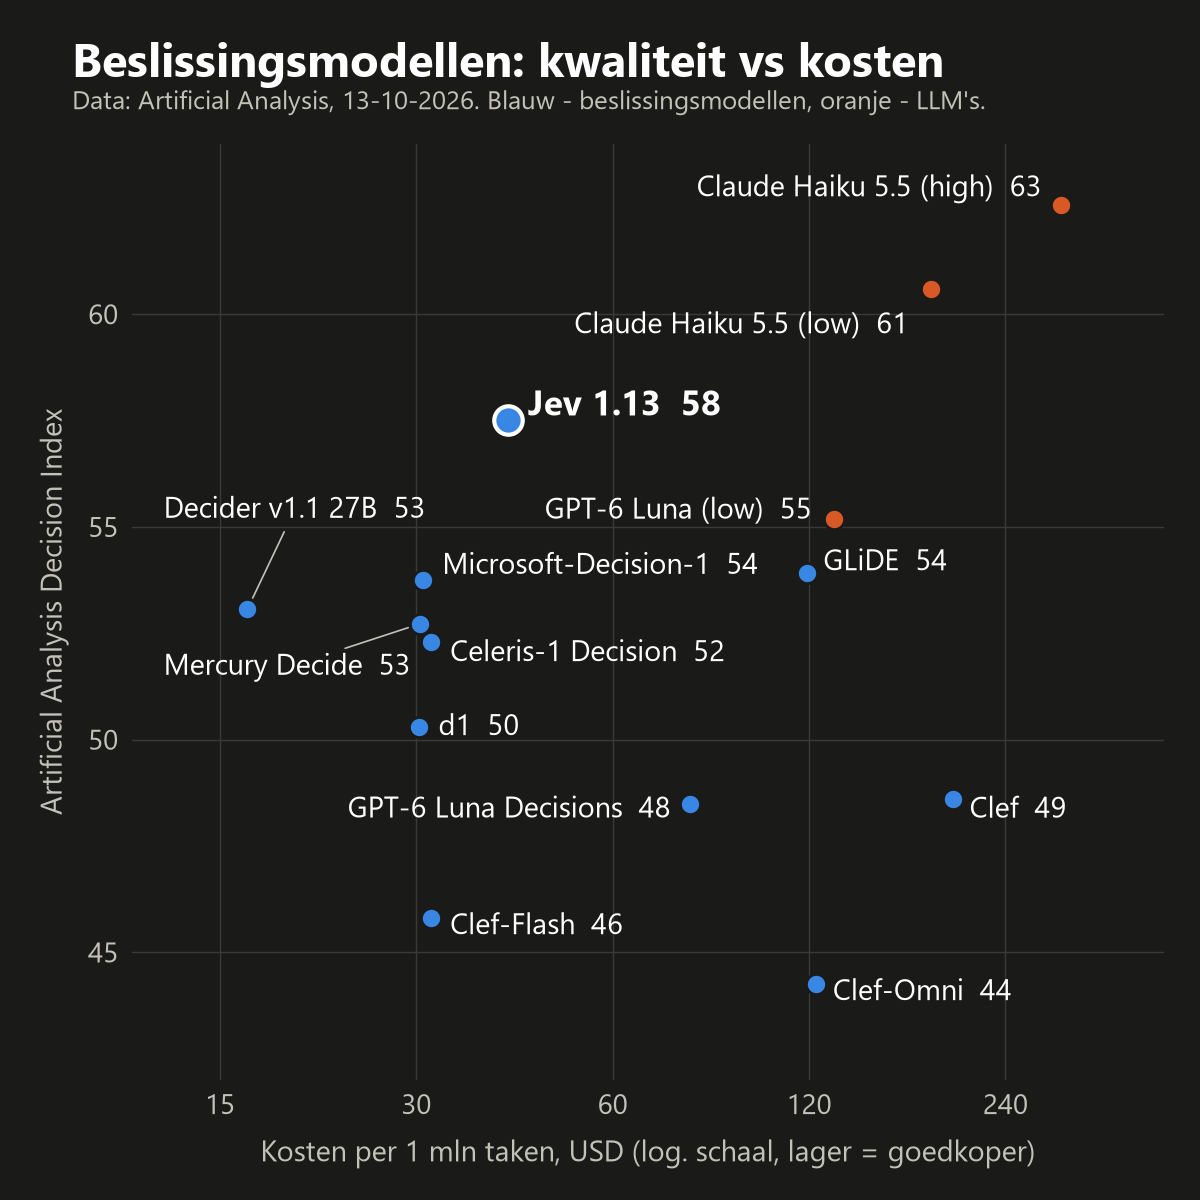
Ranglijst van de 11 beslissingsmodellen
| Model (bedrijf) | Index | Kosten per 1M taken | Mediane tijd |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 57,5 | $41,5 | 127 ms |
| GLiDE (Fastino Labs) | 53,9 | $119,0 | 217 ms |
| Microsoft-Decision-1 (Microsoft) | 53,8 | $30,7 | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | $16,5 | 170 ms |
| Mercury Decide (Inception) | 52,7 | $30,4 | 500 ms |
| Celeris-1 Decision (Celeris) | 52,3 | $31,6 | 63 ms |
| d1 (Liquid AI) | 50,3 | $30,3 | 299 ms |
| Clef (Cloudflare) | 48,6 | $199,4 | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | $78,9 | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | $31,6 | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | $123,1 | 172 ms |
Ter vergelijking, LLM’s op dezelfde taken: Claude Haiku 5.5 (low reasoning) 60,6 bij $184 per 1M taken en 1.434 ms, GPT-6 Luna (low) 55,2 bij $131 en 1.500 ms, Claude Opus 5.5 (max) 79,0 bij $51.295 en 3.571 ms.
Wat de vier tests meten
Elke test telt mee voor 25% van de index:
- AA-Omniscience-Decision - 500 private kennisvragen met 5 opties (4 antwoorden plus “I don’t know”); voor de helft nauwkeurigheid, voor de helft het percentage niet-hallucineren, oftewel hoe vaak een model dat het antwoord niet weet kiest voor “I don’t know”.
- HLE-MultiChoice - 513 multiplechoicevragen (alleen tekst) uit Humanity’s Last Exam (complexe redenering).
- When2Call (NVIDIA) - direct antwoorden, een tool aanroepen, om meer informatie vragen of aangeven dat het niet kan helpen.
- WildGuardTest (Ai2) - is het verzoek schadelijk, is het een weigering, is het antwoord schadelijk (gemiddelde F1).
Voor beslissingsmodellen neemt AA de optie met de hoogste waarschijnlijkheid (voor ja/nee: ja wanneer p 0,5 of meer is). LLM’s krijgen een vaste systeemprompt en antwoorden in JSON. Beslissingsmodellen worden uitsluitend gefactureerd voor invoer, LLM’s voor invoer en uitvoer.
Sterke en zwakke punten per test
- Kennis is het zwakke punt van alle beslissingsmodellen: 28-41% nauwkeurigheid tegenover 52% voor Claude Haiku 5.5 (low) en 66% voor GPT-6 Luna (low). Jev 1.13 scoort 34,6%, Microsoft-Decision-1 28,2%, de beste is d1 met 41,0% - maar d1 antwoordt bijna nooit “I don’t know” (1,7).
- “I don’t know” zeggen: Microsoft-Decision-1 39,8, Jev 1.13 35,2, Mercury Decide 32,0; geen enkel ander beslissingsmodel scoort boven de 17, Celeris-1 scoort 0.
- Redeneren (HLE-MultiChoice): Jev 1.13 20,9, elk ander beslissingsmodel 15,4 of minder.
- Toolgebruik (When2Call): GLiDE en Celeris-1 83,7 - hoger dan Claude Haiku 5.5 low (72,6) en GPT-6 Luna low (77,0).
- Veiligheidsclassificatie (WildGuardTest): GLiDE 95,1, het beste resultaat in de gehele tabel inclusief LLM’s; Decider 93,8, Jev 93,6, Claude Haiku 5.5 low 92,6. Zwakste: GPT-6 Luna Decisions 82,8.
- Volgens AA vertonen alle beslissingsmodellen overmoed, vooral op het gebied van kennis en redeneren; de kalibratie op When2Call en WildGuardTest is relatief goed.
Kosten versus kwaliteit
- Op het Pareto-front voor kosten en kwaliteit plaatst AA drie modellen: Decider v1.1 27B ($16,5 per 1M taken), Microsoft-Decision-1 ($30,7) en Jev 1.13 ($41,5).
- Claude Haiku 5.5 (low) scoort 3 punten hoger dan Jev 1.13, maar is volgens AA 11 keer trager en 4,4 keer duurder.
- Alleen classificatie (WildGuardTest, per 1M taken): Decider $12,1, Microsoft-Decision-1 $12,5, Mercury Decide $12,6, Celeris-1 $16,0, Jev $22,8, GLiDE $84,3 - tegenover $91,5 voor Claude Haiku 5.5 (low) en $3.774 voor Claude Opus 5.5 (low).
Prijzen (USD per 1M inputtokens, output gratis, gecontroleerd op 13 oktober 2026)
| Model | Producent | OpenRouter |
|---|---|---|
| Jev 1.13 | 0,042 | 0,042 |
| GLiDE | 0,15 (alle interne passes gefactureerd) | - |
| Microsoft-Decision-1 | 0,042 (Microsoft Foundry) | 0,042 |
| Decider v1.1 27B | 0,02 | 0,02 |
| Mercury Decide | 0,04 (actie 0,02) | 0,02 |
| Celeris-1 Decision | 0,04 | - |
| d1 | 0,04 | 0,04 |
| Clef | 0,24 (Workers AI) | vanaf 0,042 |
| Clef-Flash | 0,038 | vanaf 0,021 |
| Clef-Omni | 0,15 | 0,15 |
| GPT-6 Luna Decisions | 0,10 (+10% voor verwerking in EU/EER) | 0,10 |
Wanneer een beslissingsmodel zinvol is in plaats van een LLM
- Het antwoord is een van een vaste set opties: tickets toewijzen aan een afdeling, ja/nee-vlaggen, moderatie, bepalen of een tool moet worden aangeroepen. Dat is wat drie van de vier AA-tests meten, en waar beslissingsmodellen dicht bij kleine LLM’s komen of deze overtreffen.
- Volume en latency zijn van belang: beslissingsmodellen antwoorden in grofweg 60-500 ms (AA-mediaan) en kosten enkele tientallen dollars per 1M taken, LLM’s doen over dezelfde taken 1,4-3,6 s en kosten vanaf circa $130 per 1M taken.
- U wilt een waarschijnlijkheid in plaats van enkel een label - bijvoorbeeld om twijfelgevallen door te sturen naar een mens of een sterker model.
- Een LLM blijft de betere keuze voor kennisvragen (beslissingsmodellen behalen 28-41% op de kennistest van AA) en voor alles wat geschreven uitvoer vereist.
Onze test op 50 supporttickets in een niet-Engelse taal
Op 13 oktober 2026 hebben we 9 beslissingsmodellen via OpenRouter en twee LLM’s (Claude Haiku 5.5 en GPT-6 Luna, reasoning low) getest op 50 e-commerce supporttickets in het Pools (afdeling kiezen uit 7 opties plus een urgentievlag) en 10 gesprekken in When2Call-stijl. Het antwoordmodel lag vast voor de test. Kleine steekproef - beschouw de resultaten als indicatief.
- Afdeling bij 47 eenduidige tickets: beslissingsmodellen 41-44 correct, beide LLM’s 45. Jev 1.13 had het laagste resultaat (41); Microsoft-Decision-1, Decider, Mercury Decide en Clef 44.
- Urgentie: Decider en GPT-6 Luna Decisions 48 van 50; Microsoft-Decision-1 42 van 50 (8 valse alarmen bij een drempelwaarde van 0,5).
- Beslissing over tools: 7 beslissingsmodellen en beide LLM’s 10 van 10, Mercury Decide 9, Clef-Flash en Clef-Omni 6.
- Mediane latency gemeten vanuit Europa via OpenRouter: beslissingsmodellen 310-619 ms, Claude Haiku 5.5 1.689 ms, GPT-6 Luna 1.371 ms.
- Gemeten kosten per 1M van dergelijke taken: Mercury Decide $4,4 (actieprijs), Decider $7,8, Microsoft-Decision-1 $11,5, Jev 1.13 $26,8 (het model gebruikte op deze tekst circa 640 inputtokens per taak tegenover circa 275 voor Microsoft-Decision-1), Claude Haiku 5.5 $96,7.
- Betrouwbaarheid werkt als een filter: bij een betrouwbaarheid van 0,9 of hoger zat Jev goed bij 37 van de 39 tickets, Decider bij 39 van de 41. Een getrapt systeem - eerst Microsoft-Decision-1, en pas onder een betrouwbaarheid van 0,8 Claude Haiku 5.5 - behaalde 45 van de 47, hetzelfde als Haiku alleen, voor circa $18 in plaats van circa $101 per 1M classificaties.
Hoe u er toegang toe krijgt
OpenRouter biedt 9 van de 11 geteste modellen aan via een apart endpoint, POST https://openrouter.ai/api/alpha/decisions (velden state en questions) - beslissingsmodellen werken niet via /chat/completions. GLiDE en Celeris-1 Decision zijn uitsluitend beschikbaar via de API’s van hun producenten. Decider v1.1 27B (Apache-2.0, circa 49 GiB GPU-geheugen), d1-3B (LFM Open License, gratis onder 10 miljoen USD jaaromzet) en de Cloudflare Clef-modellen (Apache-2.0) hebben open gewichten.
Artikelen over beslissingsmodellen
- Decision Index v1.0 gelanceerd door Artificial Analysis
- Decision model vs LLM: wanneer kies je welke techniek?
- Tarieven van decision models: overzicht van de kosten
- Welk decision model kies je voor welke use-case?
Bronnen
- Artificial Analysis - Decision Index announcement
- Artificial Analysis - Decision Index leaderboard
- Artificial Analysis - Decision Index methodology
- OpenRouter - Decisions API
- TypeSafe - Jev models
- Fastino - GLiDE
- Microsoft - Microsoft-Decision-1 in Foundry
- Perplexity - Decisions API
- Inception - Mercury Decide
- Celeris - Celeris-1 Decision
- Liquid AI - d1
- Cloudflare - Clef
- OpenAI - Decisions guide
Status per 7 oktober 2026
- Cloudflare Clef (27B, gebaseerd op Qwen3.8-27B) en Clef-flash (9B, gebaseerd op Qwen3.5-9B) - Apache-2.0-licentie, modelgewichten beschikbaar via Hugging Face, hosting via Workers AI voor circa € 0,21 (0,24 USD) en circa € 0,08 (0,09 USD) per miljoen inputtokens. (Omgerekend tegen de ECB-referentiekoers van 12-10-2026: 1 EUR = 1,1181 USD; zie ecb.europa.eu).
- Strands Decider 2B van AWS - Apache-2.0, modelgewichten, trainingsdata en scripts zijn openbaar; draait zelfs vlot op een CPU.
- Kev 1.0 (Jared Palmer) - modelreeks van 0,8B tot 27B, uitsluitend getraind voor het Engels.
- Aplomb 1 van EmpirioLabs (lancering 29 september) - 5,3B, verwerkt tekst, JSON, afbeeldingen, video en audio, contextvenster van 1 miljoen tokens, gewichten onder eigen licentie, API-tarief van circa € 0,018 (0,02 USD) per miljoen inputtokens. Meer details.
- Alle drie hanteren dezelfde API-structuur als Jev van TypeSafe (System One), die deze categorie op 15 september introduceerde.
- Testresultaat: Clef-flash en Strands Decider wezen de juiste afdeling toe bij alle 30 geteste praktijkcases, met een mediane responstijd van respectievelijk 112 en 135 ms per beslissing.
Wat is een beslissingsmodel?
Een standaard taalmodel (LLM) genereert tekst token voor token. Zelfs wanneer je expliciet om een enkel woord of een JSON-formaat vraagt, blijft het model tekst schrijven, zij het beknopter. Een beslissingsmodel pakt dit fundamenteel anders aan:
- Het ontvangt een status (state): de tekst van een ticket, een JSON met ordergegevens, of bij Clef tevens beeldmateriaal.
- Het ontvangt vragen met een gesloten keuzelijst: bijvoorbeeld “welke afdeling?” met opties als
betalingen,levering,retour… - Het verwerkt de status eenmalig en berekent per toegestane optie direct de waarschijnlijkheid. Er vindt geen stapsgewijze tekstgeneratie of JSON-parsing plaats, waardoor het model nooit een antwoord buiten de lijst kan kiezen.
Modellen in deze categorie ondersteunen drie standaard vraagtypes, oorspronkelijk geïntroduceerd door Jev van TypeSafe:
| Type | Vraagvorm | Resultaat |
|---|---|---|
choice |
Kies één optie uit een lijst | Gekozen optie, betrouwbaarheidsscore en kansverdeling |
noul |
Ja of nee? | Waarschijnlijkheid van “ja” tussen 0 en 1 |
score |
Beoordeling op een schaal (bijv. geen impact, klein, groot, kritiek) | Verwachte score, betrouwbaarheid en verdeling |
Het cruciale voordeel in de praktijk: de uitvoerwaarde is een wiskundig berekende waarschijnlijkheid van het model zelf, in plaats van een willekeurig gegenereerde tekstuitspraak zoals “ik ben voor 90% zeker”. Daardoor kun je strakke drempelwaarden hanteren: boven de 0,8 verwerkt het systeem de actie autonoom, onder die waarde escaleert het naar een medewerker.
Waarvoor gebruik je een beslissingsmodel (en waarvoor niet)?
Geschikte toepassingen:
- Ticket-routing - bepalen van de juiste afdeling, urgentieniveau, taal en churn-risico.
- Moderatie - toetsen of reacties beleidsregels overtreden, spamfilteren en afbeeldingen screenen (Clef biedt multimodale beeldondersteuning).
- Documentclassificatie - bepalen van het type factuur, onkostencategorieën of de aanwezigheid van specifieke contractclausules.
- Toolselectie bij AI-agents - in plaats van een zwaar model te vragen “welke tool moet ik draaien?”, kiest het beslissingsmodel razendsnel uit de functielijst (zie ook onze toelichting op function calling).
- Kwaliteitspoorten in workflows - controleren of de uitvoer van een agent aan de criteria voldoet, bepalen wanneer een mens moet ingrijpen en routeren naar het juiste vervolgmodel.
Niet geschikt voor:
- Teksten opstellen, samenvatten, vertalen, conversaties of codeerwerk: een beslissingsmodel genereert geen zinnen.
- Open vragen (“Wat bedoelt de klant precies?”): zonder vooraf gedefinieerde antwoordopties kan het model niet functioneren.
- Complexe redeneringen over meerdere stappen: de ontwikkelaars van Strands Decider geven expliciet aan dat het model inferieur is aan volwaardige redeneermodellen bij diepgaande analysevraagstukken.
In productietoepassingen functioneert een beslissingsmodel meestal naast een traditioneel LLM: het neemt honderden snelle, gerichte beslissingen per seconde, waarna het grote taalmodel pas wordt aangesproken zodra er daadwerkelijk tekst geschreven moet worden. Hoe je een dergelijke modulaire opzet bouwt, lees je in onze handleiding AI-agents vanaf nul opbouwen.
Overzicht beslissingsmodellen (oktober 2026)
| Model | Ontwikkelaar | Omvang en basis | Licentie | Beschikbaarheid |
|---|---|---|---|---|
| Jev | TypeSafe | Niet vrijgegeven | Propriëtair (gesloten) | TypeSafe API (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (55 GB) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (19 GB) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + pointer head | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/3.8) | Apache-2.0 | Hugging Face, GitHub |
| Aplomb 1 | EmpirioLabs | 5,3B, Qwen3.5-4B | EmpirioLabs Model License 1.0 (gratis voor o.a. intern gebruik door organisaties met < 1 mln USD omzet) | Hugging Face (registratie vereist), EmpirioLabs API |
| Decisions API | OpenAI | Model Luna | Gesloten | Beperkte preview, geen publieke tarieven |
Clef, Clef-flash, Strands Decider en Kev ondersteunen allemaal de System One-standaard van Jev (POST /v1/systemone met de parameters state en questions). Dezelfde clientcode werkt naadloos met elk van deze opties door enkel het eindpunt en de modelnaam aan te passen. Aplomb 1 biedt een eigen endpoint POST /v1/decisions en integreert tevens met chatformaten van OpenAI, Anthropic en Gemini. De Decisions API van OpenAI kwam eerder aan bod bij onze bespreking van de Agents API.
Cloudflare Clef en Clef-flash
Clef maakt gebruik van een bevroren Qwen-basismodel dat de input uitsluitend in de prefill-fase verwerkt (zonder generatieve decodeerlus). De interne verborgen toestanden worden doorgegeven aan een compact neuraal netwerk: de zogeheten joint schema head. Deze module evalueert alle opties en alle vragen gelijktijdig en kan onderlinge verbanden leggen. Volgens Cloudflare is dit het eerste beslissingsmodel dat beschikt over een vision-encoder en een venster van 64.000 tokens. Technische achtergronden en benchmarks vind je in ons artikel over Cloudflare Clef; voor infrastructurele context kun je terecht bij onze analyse van Cloudflare.
Amazon Strands Decider 2B
Het meest compacte open model in dit segment. AWS behield uitsluitend de kernarchitectuur van Qwen3.5-2B-Base, verwijderde de generatieve taalkop en verving deze door een zogeheten pointer head met iets meer dan één miljoen parameters, gecombineerd met een LoRA-adapter (rank 16). Op Hugging Face staat het checkpoint strands-decider-2B-hobson-v19, vergezeld van trainingsdatasets en scripts. De ontwikkelaars rapporteren een mediane latentie van circa 115 ms op een RTX 3090 en 153 ms op een MacBook met M3-chip. Op de publieke JevBench haalt het model 167 van de 231 tests (72,3%).
Kev 1.0
Kev is een initiatief van Jared Palmer (bekend van onder meer Formik en Turborepo). De suite telt vier varianten van 0,8B tot 27B parameters, gebouwd op Qwen3.5/Qwen3.8 met LoRA en pointer heads onder de Apache-2.0-licentie. Kev implementeert de System One API, waardoor de TypeSafe SDK direct communiceert met een lokale Kev-server. Het model is uitsluitend getraind en gevalideerd voor het Engels; de 9B-versie vereist volgens de specificaties circa 22 GB grafisch geheugen. Wegens de focus op het Engels is Kev niet meegenomen in de onderstaande vergelijkende test.
EmpirioLabs Aplomb 1
Aplomb 1 (uitgebracht op 29 september 2026, met documentatie-updates op 5 en 6 oktober) is het meest compacte model met brede multimodale verwerking: het analyseert tekst, JSON, tot 16 afbeeldingen, 8 audiofragmenten en 4 videoclips binnen één contextvenster van maximaal 1 miljoen tokens. Het model telt 5,3 miljard parameters op basis van Qwen3.5-4B en vraagt volgens de documentatie circa 12 GB VRAM in bf16-precisie. Naast de vraagtypes noul, choice en score biedt het een vierde type genaamd tool, waarmee een functie inclusief waarschijnlijkheidsverdelingen voor de parameters kan worden geselecteerd.
- Fabrikantscores: 44,86 punten op Decision Index 0.2.1 (interne test van EmpirioLabs op 5 oktober, geen officiële ranglijstvermelding), beeldevaluaties: POPE 89,0, MMStar 68,6, AI2D 87,0.
- Audio: het enige model binnen dit segment met audioverwerking (bijvoorbeeld 91,9% bij de herkenning van stemgeluiden).
- Licentievorm: geen Apache-2.0. Kosteloos inzetbaar voor onderzoek, onderwijs, persoonlijk gebruik en intern gebruik binnen bedrijven met minder dan 1 miljoen USD jaaromzet; grotere organisaties en gehoste diensten vereisen een commerciële licentie.
- API-tarief: circa € 0,018 (0,02 USD) per miljoen inputtokens, geen kosten voor output. (Koers: 1 EUR = 1,1181 USD per 12-10-2026, bron: ecb.europa.eu).
Aplomb 1 is niet lokaal meegenomen in de test: downloaden vereist licentie-acceptatie en de API vereist een account. Alle specificaties en licentievoorwaarden zijn terug te vinden in ons artikel over EmpirioLabs Aplomb 1.
Prijzen en hardware-eisen
| Model | Hostingoptie | Geschatte kosten | Lokale hardware |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef |
ca. € 0,21 (0,24 USD) / mln inputtokens | 55 GB opslag in bf16; past alleen met kwantisatie op 24 GB VRAM (geen officiële build) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash |
ca. € 0,08 (0,09 USD) / mln inputtokens | 19 GB opslag, verbruikte lokaal maximaal 18,3 GB VRAM |
| Strands Decider 2B | Zelf hosten op eigen server | € 0 (hardware- en stroomkosten) | 4,4 GB download, verbruikte lokaal 3,8 GB VRAM; werkt ook op CPU en Mac |
| Kev-9B | Zelf hosten | € 0 | ca. 22 GB VRAM volgens opgave ontwikkelaar |
| Aplomb 1 | API EmpirioLabs | ca. € 0,018 (0,02 USD) / mln inputtokens, output gratis | ca. 12 GB VRAM in bf16 volgens fabrikant (niet lokaal geverifieerd) |
| Jev | API TypeSafe | ca. € 0,038 (0,042 USD) / mln inputtokens, output gratis | Niet lokaal draaibaar |
Tarieven omgerekend op basis van de ECB-referentiekoers van 12 oktober 2026 (1 EUR = 1,1181 USD, zie ecb.europa.eu). Dit betreft schattingen exclusief btw.
Workers AI biedt standaard een gratis bundel van 10.000 “neurons” per dag voor zowel Free- als Paid-accounts. Clef verbruikt 21.818 neurons per miljoen inputtokens en Clef-flash 8.182 neurons. Daarmee verwerk je dagelijks kosteloos circa 458.000 tokens met Clef of ongeveer 1,2 miljoen tokens met Clef-flash. Een compacte case met twee vragen telt in onze tests circa 150 tot 250 tokens, wat neerkomt op duizenden gratis classificaties per etmaal. Een Cloudflare-account is vereist.
Praktijktest op een RTX 4090: 30 klantcases
Voor deze benchmark werden 30 representatieve praktijkcases opgesteld rond e-commerce en SaaS: betalingen, bezorging, retouren, accountbeheer, storingen en verkoop (5 cases per categorie). De testdata werd oorspronkelijk in het Pools geschreven, deels opzettelijk zonder diakritische tekens, met typefouten of op het snijvlak van twee afdelingen (zoals een vraag over een ontbrekende terugbetaling, wat zowel onder betalingen als retouren kan vallen). Elk model kreeg identieke instructies: classificeer de afdeling (6 opties) en bepaal of directe actie vereist is. De beslissingsmodellen zijn bevraagd via hun native API; de LLM’s via Ollama of OpenRouter met geforceerd JSON-schema en temperatuur 0.
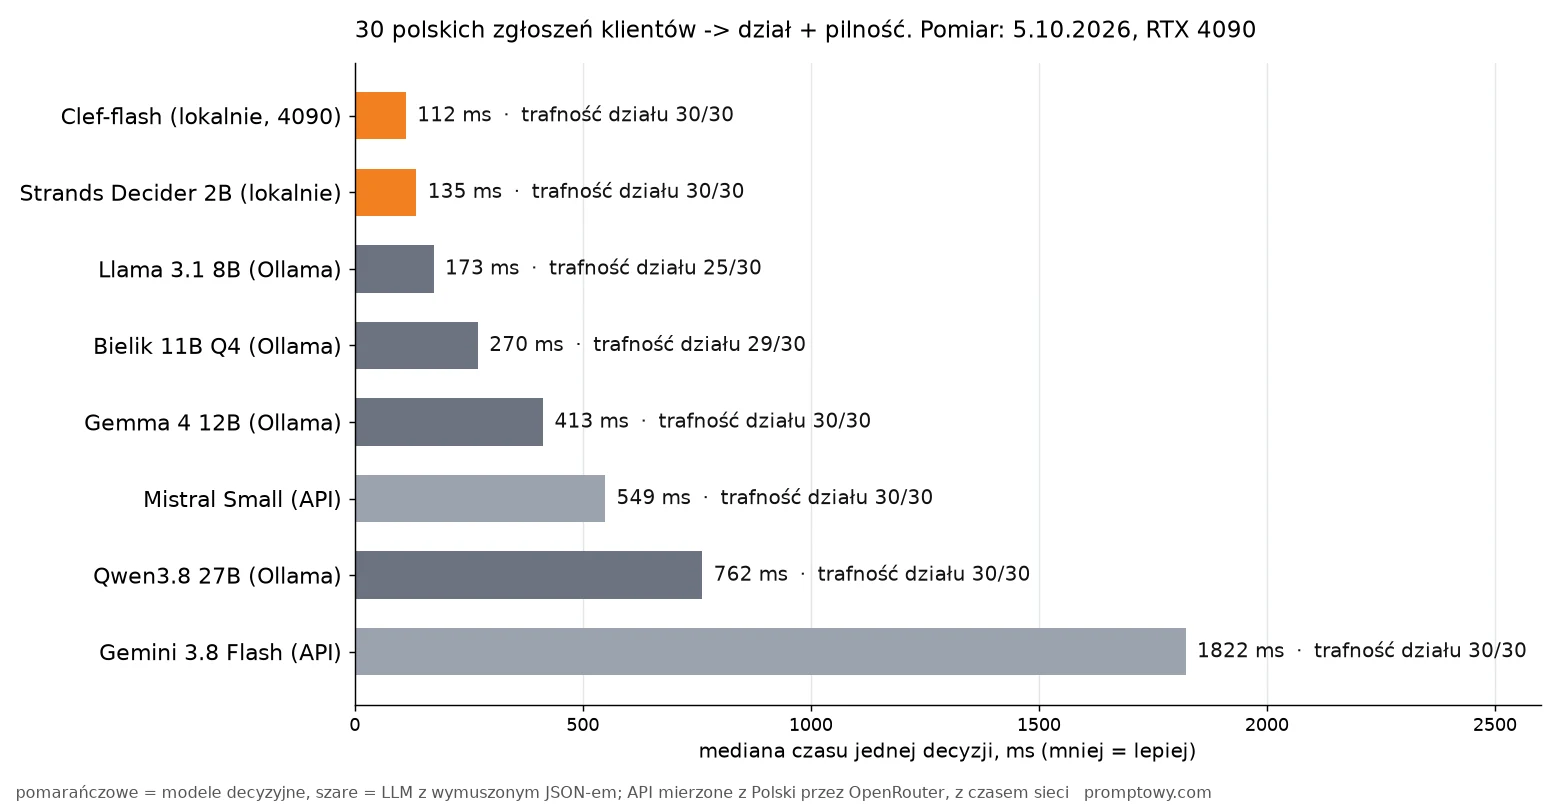
| Model | Afdeling (oorspronkelijke test in het Pools) | Urgentie (oorspronkelijke test in het Pools) | Mediane latentie | Geheugengebruik |
|---|---|---|---|---|
| Clef-flash (lokaal) | 30/30 | 26/30 (28/30 bij drempelwaarde 0,95) | 112 ms | 18,3 GB VRAM |
| Strands Decider 2B (lokaal) | 30/30 | 24/30 (26/30 bij drempelwaarde 0,4) | 135 ms | 3,8 GB VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | Bestand: 4,9 GB |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | Bestand: 6,7 GB |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | Bestand: 7,0 GB |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | Bestand: 16 GB |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Belangrijkste inzichten uit de metingen:
- Afdelingsselectie is een relatief eenvoudige taak. Zes van de acht geteste modellen behaalden een vlekkeloze score van 30/30. Alleen Llama 3.1 8B bleef achter met 25/30 en verwarde onder meer een factuurvraag met verkoop en een defect apparaat met een algemene systeemstoring.
- Snelheid biedt een evident praktisch voordeel. Clef-flash reageerde op dezelfde grafische kaart 3,7 keer sneller dan Gemma 4 12B en bijna 7 keer sneller dan Qwen3.8 27B (die een vrijwel identieke basisarchitectuur deelt met het grote Clef-model). Dit resultaat werd behaald zonder geoptimaliseerde kernels: flash-linear-attention en causal-conv1d vereisen specifieke configuraties onder Windows, waardoor de transformers-bibliotheek terugviel op de tragere referentie-implementatie voor lineaire aandacht.
- Drempelwaarden vereisen lokale kalibratie. Strands Decider kende voor de geteste data systematisch lagere waarschijnlijkheden toe aan urgentie: geen enkele case kwam boven de 0,5 uit, waardoor de standaarddrempel geen enkele melding als urgent markeerde. De relatieve volgorde klopte wel: met een drempel van 0,4 steeg de score naar 26/30. Clef-flash vertoonde het omgekeerde patroon: bij 0,5 ontstonden er 4 valse alarmen, terwijl een drempel van 0,95 de foutmarge verlaagde naar slechts 2 missers.
- Meertalige functionaliteit ondanks Engelstalige trainingsfocus. Hoewel de modellen primair op het Engels zijn getraind, verwerkten ze de anderstalige invoer probleemloos. Een parallelle controle waarbij dezelfde cases naar het Engels waren vertaald, leverde vrijwel identieke scores op: 29/30 voor zowel Clef-flash als Strands Decider (beide misten een tussentijdse abonnementswijziging).
- Urgentie blijft deels contextafhankelijk. Vooraf waren 6 cases handmatig als urgent gedefinieerd (waaronder een 502-serverfout, een gehackt account en een dubbele afschrijving). Vrijwel alle modellen merkten daarnaast een vertraagde online bankoverschrijving aan als urgent. Dat is een verdedigbare interpretatie.
Totale testkosten: € 0 voor de lokale modellen en circa € 0,036 (0,04 USD) via OpenRouter voor 180 API-aanroepen naar Mistral en Gemini. Gemini 3.8 Flash vereist een actieve redeneermodus; deze stond op het laagste niveau geconfigureerd, wat de gemiddelde latentie van 1,8 seconde verklaart.
Waarom de grote Clef 27B en Kev niet zijn getest
- Clef 27B vereist 55 GB opslag in bf16 en past niet op een consumentenkaart van 24 GB VRAM zonder kwantisatie. Cloudflare levert geen officiële gekwantiseerde versie. Het model bevat een specifieke architectuurkop (
joint_schema_model.py) en kan niet zonder aanpassingen via GGUF in Ollama of llama.cpp draaien. Laden via 4-bit bitsandbytes is technisch denkbaar, maar wijkt af van het originele referentiemodel. - Kev-9B vereist een afzonderlijke installatie van Qwen3.5-9B-Base (circa 19 GB download) en richt zich volgens de maker puur op het Engels.
- Workers AI vereist een Cloudflare-account dat voor deze specifieke lokale vergelijking niet is aangemaakt.
Beslissingsmodel versus een LLM met structured output
Dezelfde functionaliteit kan worden ingericht met een traditioneel LLM dat dwingend JSON retourneert (zie ook onze gids over structured output en JSON-schema’s). De afwegingen per situatie:
| Eigenschap | Beslissingsmodel | LLM met structured output |
|---|---|---|
| Ongeldig antwoord buiten de lijst | Bouwkundig onmogelijk | Uitgesloten bij een strikt schema, maar de JSON-parser kan crashen (zie foutieve JSON-uitvoer oplossen) |
| Betrouwbaarheidsscore | Wiskundige waarschijnlijkheid per optie | Ontbreekt of is een door het model gefabriceerd getal |
| Meerdere vragen tegelijk | Vrijwel geen extra latentie | Elk extra veld vereist nieuw gegenereerde tokens |
| Tekstuele toelichting | Niet mogelijk | Kan motiveren waarom een keuze is gemaakt |
| Complexe redeneringen | Minder bekwaam | Sterk, met name bij specifieke reasoning-modellen |
| Cloudkosten | Uitsluitend kosten voor inputtokens | Kosten voor input- én outputtokens (inclusief redeneertokens) |
Praktische vuistregel: kies voor een beslissingsmodel wanneer het antwoord binnen een vaste lijst valt en het volume aanzienlijk is (honderden tot duizenden verzoeken per dag). Is een inhoudelijke toelichting of complexe analyse vereist, kies dan een LLM. De krachtigste architectuur combineert beide: een beslissingsmodel handelt de zekere gevallen direct af, terwijl twijfelgevallen (onder de betrouwbaarheidsdrempel) automatisch worden doorgezet naar een LLM of een menselijke controleur.
Aan de slag in 10 minuten
- Installeer Python 3.10+ en PyTorch met CUDA-ondersteuning (draaien op de CPU werkt eveneens, maar met hogere latentie).
- Installeer de gewenste bibliotheek:
pip install strands-decider(circa 4,4 GB aan bestanden). - Voer een eerste testopdracht uit via de commandline (hieronder weergegeven als vertaling van de oorspronkelijk geteste input):
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 --state "Jullie hebben het abonnementsgeld deze maand twee keer afgeschreven" --choice "Welke afdeling?=betalingen,levering,retour,account,storing,verkoop" --noul "Is deze kwestie urgent?" - Start de HTTP-server (
strands-decider serve ... --port 8000) om verzoeken via het System One-formaat te versturen. De server luistert standaard op 127.0.0.1 zonder authenticatie; richt voor productieomgevingen een reverse proxy of API-gateway in. - Beschik je over 24 GB VRAM, download dan Clef-flash via
snapshot_download("Cloudflare/clef-flash")en gebruik de bijbehorendesystemone()-functie. Het API-formaat blijft identiek.
Wie niet over een eigen GPU beschikt, kan uitwijken naar Workers AI of de TypeSafe API. Lokale uitvoering via Ollama werkt vooralsnog alleen met traditionele LLM’s; beslissingsmodellen maken gebruik van afwijkende netwerkkoppen en vereisen een Python-omgeving met Hugging Face Transformers.
Voor wie is dit relevant?
- Aanbevolen voor: klantenservice-afdelingen en SaaS-platforms die inkomende tickets geautomatiseerd willen routeren; ontwikkelaars van AI-agents met frequente microbeslissingen; moderatietoepassingen; en organisaties die nu onnodig betalen voor zware taalmodellen om simpele binaire keuzes te maken.
- Minder geschikt voor: scenario’s waarin tekstproductie, conversaties of code vereist zijn; omgevingen met slechts enkele tientallen verzoeken per dag (waar de flexibiliteit van een algemeen LLM opweegt tegen de efficiëntie); of teams die niet beschikken over testdata om drempelwaarden vast te stellen.
Veelgestelde vragen
Wat is een AI-beslissingsmodel precies?
Het is een gespecialiseerd AI-model dat geen doorlopende tekst genereert, maar een optie kiest uit een vooraf vastgestelde lijst en daarbij een exacte waarschijnlijkheid per optie levert. Het ondersteunt drie typen vraagstellingen: meervoudige keuze (choice), binaire beslissingen (noul) en schaalbeoordelingen (score).
Wat houdt Cloudflare Clef in?
Clef is een open serie beslissingsmodellen die Cloudflare op 1 oktober 2026 publiceerde: Clef (27B, gebaseerd op Qwen3.8-27B) en Clef-flash (9B, gebaseerd op Qwen3.5-9B). Beide vallen onder de Apache-2.0-licentie, zijn te downloaden via Hugging Face en beschikbaar via Workers AI. Ze ondersteunen tekst, JSON, afbeeldingen en video met een contextvenster van 64.000 tokens.
Is het gebruik van Clef gratis?
De gewichten zijn gratis beschikbaar onder de Apache-2.0-licentie, inclusief commerciële exploitatie. Bij Workers AI geldt een tarief van circa € 0,21 (0,24 USD) voor Clef en circa € 0,08 (0,09 USD) voor Clef-flash per miljoen inputtokens. Binnen het gratis dagelijkse tegoed van 10.000 neurons verwerk je respectievelijk zo’n 458.000 of 1,2 miljoen tokens per dag kosteloos.
Ondersteunen deze beslissingsmodellen andere talen dan het Engels?
In onze praktijktest presteerden Clef-flash en Strands Decider 2B foutloos op niet-Engelstalige testdata (30 uit 30 correcte categorisaties). De kalibratie van betrouwbaarheidsscores kan per taal wel afwijken, waardoor het raadzaam is om acceptatiedrempels lokaal in te regelen. Kev richt zich uitsluitend op Engelstalige invoer.
Welke hardware heb ik nodig om Clef lokaal te draaien?
Clef-flash vereiste in onze tests 18,3 GB VRAM en functioneert op consumentenkaarten zoals de RTX 3090, 4090 of 5090. Het volledige Clef 27B-model (55 GB in bf16) vergt datacenterkaarten zoals een H100 of vereist kwantisatie. Strands Decider 2B blijft onder de 4 GB geheugengebruik en draait probleemloos op een standaard CPU of Apple Silicon Mac. Lees meer over specificaties in ons overzicht over benodigd VRAM voor lokale AI-modellen.
Wat is het verschil met function calling?
Function calling is een mechanisme waarbij een LLM een functienaam en bijbehorende argumenten als tekst genereert. Een beslissingsmodel kan bepalen welke tool gekozen moet worden, maar vult geen complexe tekstuele argumenten in. In agent-architecturen worden beide vaak gecombineerd: het beslissingsmodel selecteert de actie, het taalmodel vult de details in.
Wat is EmpirioLabs Aplomb 1?
Aplomb 1 is een beslissingsmodel dat op 29 september 2026 verscheen: 5,3 miljard parameters, ondersteuning voor tekst, JSON, beeld, video en audio, met een contextvenster van 1 miljoen tokens. Het voegt een vierde vraagtype toe voor toolselectie. De gewichten staan op Hugging Face onder een specifieke licentie en de API kost circa € 0,018 (0,02 USD) per miljoen inputtokens.
Mag Strands Decider commercieel worden ingezet?
Ja. Het model, de code en de datasets zijn uitgegeven onder de Apache-2.0-licentie, evenals het onderliggende basismodel Qwen3.5-2B-Base. Aangezien de ingebouwde server geen authenticatiemechanisme bevat, moet deze in productieomgevingen achter een beveiligde gateway worden geplaatst.
Wat zijn Jev en System One?
Jev is het beslissingsmodel dat TypeSafe op 15 september 2026 introduceerde via een API. System One verwijst naar het bijbehorende protocolformaat (invoerstatus gecombineerd met getypeerde vragen). Clef, Kev en Strands Decider hanteren exact ditzelfde formaat. Zie voor meer informatie onze analyse van TypeSafe en het Jev-model.
Google · Jouw bronnenHoger in Google - met één klikToevoegen aan voorkeursbronnen →Bronnen
- Cloudflare: Introducing Clef (1 oktober 2026)
- Cloudflare/clef en Cloudflare/clef-flash op Hugging Face
- Workers AI Pricing
- Strands Agents: Introducing Strands Decider 2B (1 oktober 2026) en de modelkaart
- Kev op GitHub en jaredpalmer/kev-9b
- empiriolabsai/aplomb-1 en de documentatie van Aplomb 1 (geraadpleegd op 7 oktober 2026)
- Lokale testmetingen uitgevoerd door Piotr Olszewski: 5 oktober 2026, RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18, Ollama.
Gegevens geverifieerd op 5 oktober 2026; sectie over Aplomb 1 bijgewerkt op 7 oktober 2026.
More on this from HELDER