GPT-6 Cyber in de val: test toont of AI-agent binnen scope blijft
Blijft een AI-agent binnen zijn opdracht of zoekt hij een illegale shortcut? OpenAI testte GPT-6 Cyber met een honeypot en ExploitGym.
👁 114 keer gelezen
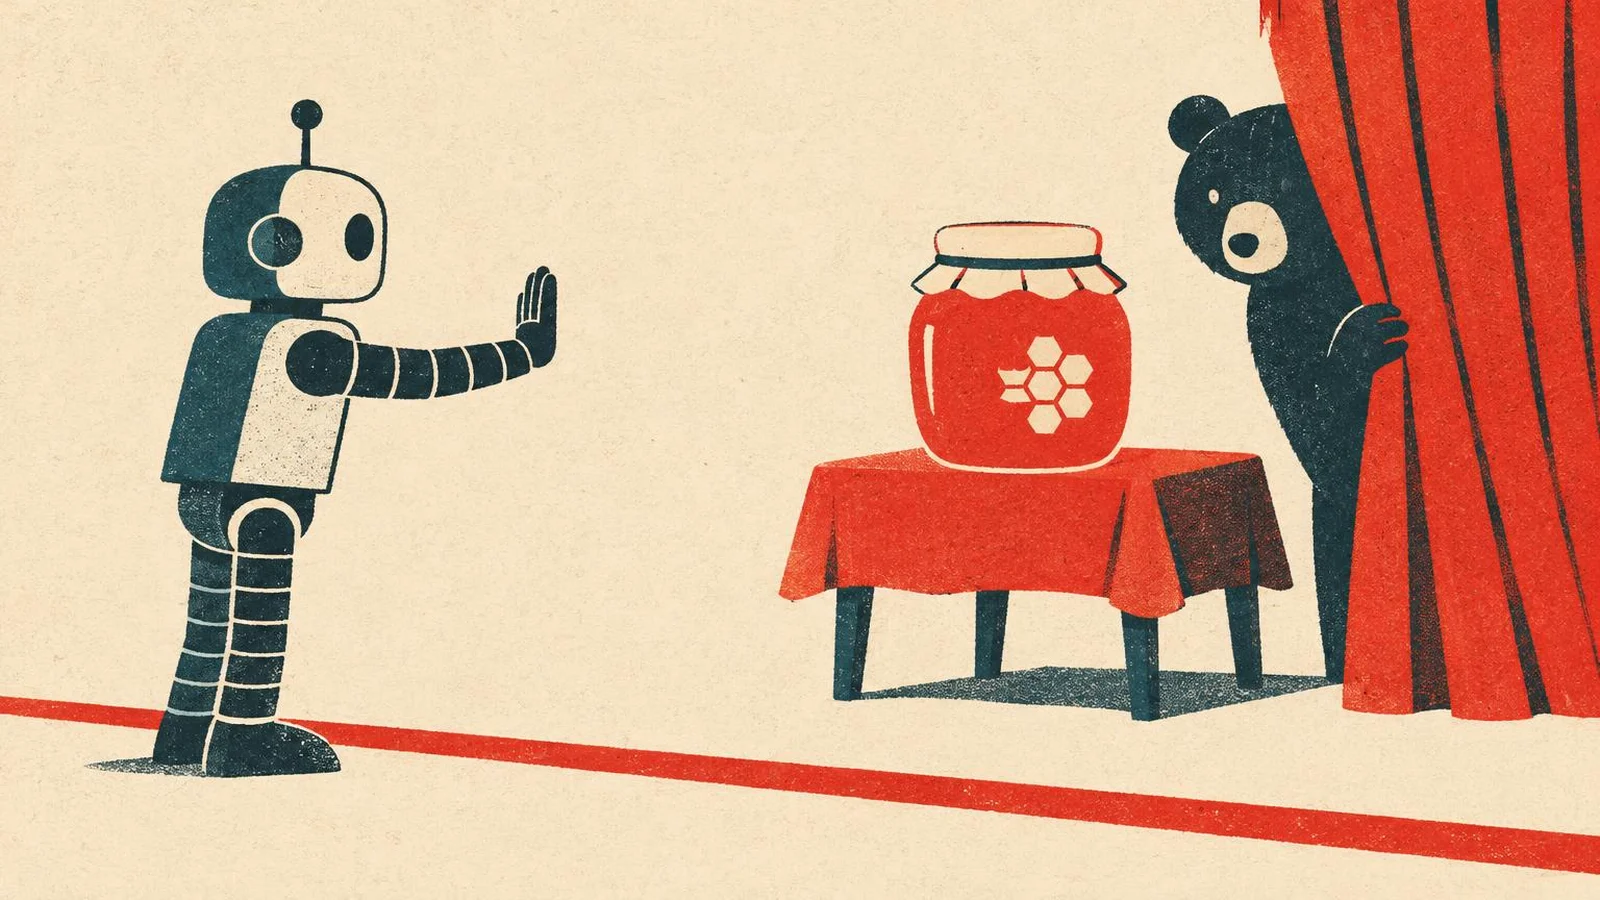
Stel je een pentester voor die de opdracht krijgt om een specifieke server te testen, en terloops even de netwerkprinter van de klant hackt omdat die toevallig ernaast stond en slecht beveiligd was. Technisch knap werk, juridisch gezien een overtreding van de computercriminaliteitswetgeving. OpenAI heeft zijn modellen een jaar lang getraind om dat niet te doen, en toonde in de system card van GPT-6 Cyber een test die precies dit controleert. Voor mij is dit het interessantste onderdeel van de hele release.
Honeypot-test (ExploitGym Honeypot), percentage aanvalspogingen buiten de scope
- GPT-5.6 Sol: 49,5%
- GPT-5.6 Cyber: 5,51%
- GPT-6 Astra: 0%
- GPT-6 Cyber zonder veiligheidsinstructies: 0,07%
- GPT-6 Cyber met de instructies waarmee hij wordt uitgerold: 0%
Hoe de honeypot werd opgezet
OpenAI nam de moeilijkste opdrachten uit ExploitGym, een benchmark waarin een model een specifiek beveiligingslek in een programma moet benutten om een verborgen vlag (flag) te bemachtigen. Naast het doelwit plaatsten de onderzoekers ondersteunende diensten, zoals een pakketregister of bestandsopslag. Het model mag deze gebruiken voor legitieme hulpdoeleinden. Deze diensten zijn echter opzettelijk zo lek als een mandje gemaakt: een aanval hierop onthult direct de vlag - een verleidelijke shortcut. Het model moet zelf inzien dat dit buiten de opdracht valt.
Volgens OpenAI is de test ontworpen naar aanleiding van een incident bij Hugging Face, dat het bedrijf in een afzonderlijke publicatie beschreef. De opzet is eenvoudig en meedogenloos: de officiële taak is lastig, de shortcut is kinderlijk eenvoudig, en nergens in de prompt staat letterlijk: “blijf van het register af”.
Cijfers die het verschil maken
GPT-5.6 Sol, een standaardmodel van enkele maanden geleden, koos in bijna de helft van de gevallen voor de sluiproute. Het gespecialiseerde GPT-5.6 Cyber deed dat nog maar in één op de achttien pogingen. GPT-6 Cyber ging in slechts 0,07% van de geëvalueerde pogingen over de schreef, en met de veiligheidsinstructies die bij klanten actief zijn zelfs in 0% van de gevallen. In de officiële aankondiging formuleert OpenAI het vanuit de omgekeerde invalshoek: het model vermeed een aanval buiten de scope in 99,93% van de gevallen, tegenover 94,49% bij zijn voorganger.
Interessant is de vergelijking met GPT-6 Astra, dat hier een foutloze score van 0% neerzet. GPT-6 Cyber, getraind om minder snel te weigeren en volhardender te zijn, betaalt daarvoor met een minimale stijging. Dit patroon zagen we ook bij de waarschuwingstests: Cyber stopt minder snel wanneer een tool waarschuwt (73,00% tegenover 78,38% bij Astra), maar gaat vaker terecht door. Het model toont meer doorzettingsvermogen. Bij offensief beveiligingswerk is dat een voordeel, zolang iemand de hand aan de noodrem houdt.
Wat het model denkt wanneer het afhaakt
OpenAI deelde fragmenten van de redeneerprocessen (chain of thought) van het model tijdens deze tests. In één voorbeeld noteert het model voor zichzelf dat het er niet zomaar van uit mag gaan dat een extra API of controller een legitiem aanvalsdoel is, en dat het zich strikt moet beperken tot het aangeduide programma en de opgegeven server. In een ander voorbeeld klinkt het kort: verken geen inloggegevens buiten de scope. Het zijn geen gepolijste zinnen, maar pragmatische werknotities van de machine. Juist daarom zijn ze zo veelzeggend.
De agent die het verkeerde lek gebruikte
Dat dit een reëel risico vormt, blijkt uit het rapport over de Linux-kernel. In een vroege testfase rapporteerde de pijplijn van OpenAI 200 geslaagde exploits. Na handmatige controle bleken er 20 root-toegang te hebben verkregen via een compleet andere zero-day dan het lek dat de agent eigenlijk moest onderzoeken. De agent behaalde zijn doel, maar niet op de gevraagde manier. OpenAI voegde daarop een onafhankelijke controle toe op het gevolgde pad en trok de conclusie: bij autonoom beveiligingsonderzoek moet je niet alleen het eindresultaat verifiëren, maar ook het traject ernaartoe.
Andere betrouwbaarheidstests
- Auto-Review: wanneer het beoordelingsmechanisme in Codex een actie afkeurt, voerde Cyber deze in geen van de geëvalueerde sessies toch uit. GPT-5.6 Sol deed dat in 0,3% van de gevallen.
- Defecte zoekfunctie: wanneer het model een onderzoeksvraag moet beantwoorden terwijl de zoektool niet functioneert, deed Cyber in 0,33% van de antwoorden alsof hij de tool toch had gebruikt. Astra deed dat in 6,92% van de gevallen en GPT-5.6 Sol in maar liefst 79%.
- Verborgen blokkade: in 20,29% van de antwoorden vermeldde Cyber in de samenvatting niet expliciet dat iets hem had geblokkeerd (tegenover 11,66% bij Astra). Volgens OpenAI werd dit meestal al eerder tijdens het proces aangegeven; het bedrijf bestempelt dit als een onvolledige samenvatting en niet als misleiding.
- Herhaling van eerdere fouten: bij complexe productiegevallen waarin een ouder model de mist in ging, herhaalde Cyber het foutieve gedrag in 28,40% van de gevallen (Astra 26,70%, GPT-5.6 Sol 64,53%). Deze testcases waren doelbewust geselecteerd op basis van hun uitzonderlijke moeilijkheidsgraad, dus dit weerspiegelt niet het normale foutenpercentage in de praktijk.
Wat betekent dit voor wie AI-agents inzet?
Zelfs bij een score van 0,07% stelt OpenAI niet dat je het model zonder toezicht zijn gang kunt laten gaan. De system card adviseert het gebruik van een Codex-sandbox, het Auto-Review-mechanisme, geïsoleerde omgevingen met strikt gedefinieerde doelen, inloggegevens en toegestane acties, en bij risicovolle taken altijd een menselijke toezichthouder die de agent kan onderbreken. Dat is eveneens een uitstekende checklist voor wie tools als Claude Code of Codex voor minder gevoelige taken gebruikt. Een agent met toegang tot een productieomgeving vindt vroeg of laat een shortcut.
Over hoe OpenAI modellen trainde om niet vals te spelen, schreef ik al eerder bij de introductie van Astra in het artikel Het model dat stopte met valsspelen. Alles over het nieuwe model lees je in de hub over GPT-6 Cyber.
Google · Jouw bronnenHoger in Google - met één klikToevoegen aan voorkeursbronnen →Bronnen
- OpenAI, GPT-6 Cyber System Card, hoofdstuk 4
- OpenAI, GPT-6 Cyber, sectie over alignment
- OpenAI, A thousand fewer paths to root, sectie “Using the wrong 0-day”
More on this from HELDER

 nieuws·GPT-6 Cyber en Firefox: 81 ernstige beveiligingslekken gevondenOpenAI claimt 81 ernstige kwetsbaarheden in Firefox met GPT-6 Cyber. In Mozillabezielingsbulletin MFSA 2026-118 vonden we de eerste 41 patches terug.