Muse Wonder vs Opus 5.5 vs GPT-6 Astra: test op 23 taken
We testten Muse Wonder, Claude Opus 5.5, Fable 5.1, GPT-6 Astra en Gemini 3.8 Flash op 23 taken: agents, code en documenten. Dit zijn de resultaten en kosten.
Update (9 november 2026): Claude Fable 5.2 en Mythos 5.2 zijn uit - prijzen, toegang en benchmarks in mijn gids over Claude Fable 5.2.
👁 125 keer gelezen
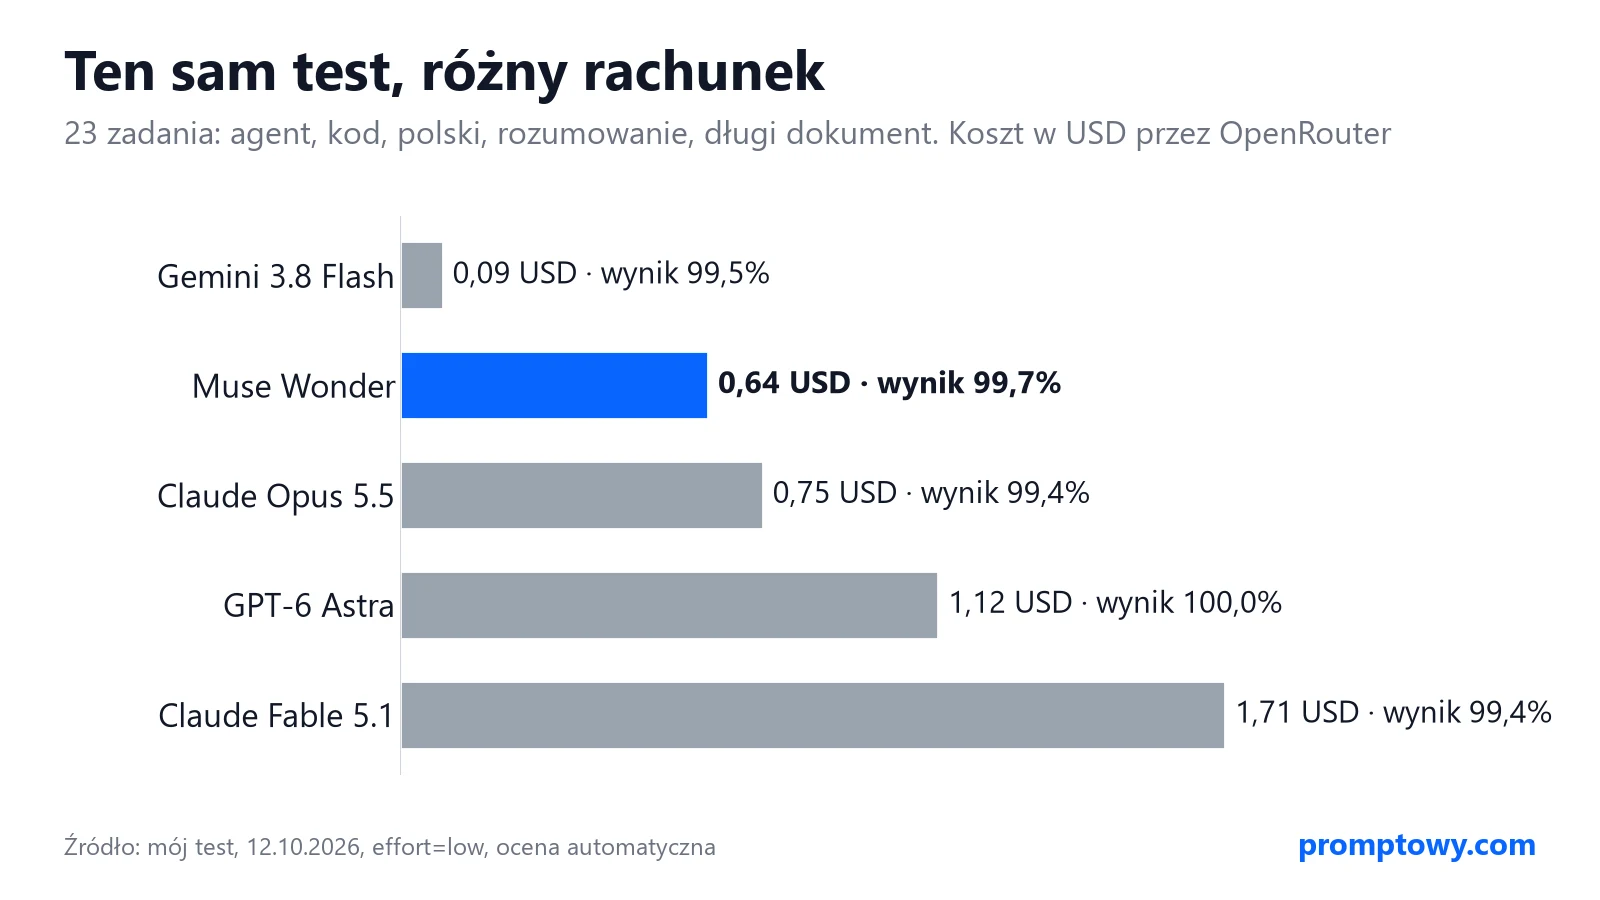
Ik legde Muse Wonder en vier concurrenten exact dezelfde 23 taken voor: een agent met tools, code gecontroleerd met geautomatiseerde unit tests, formele documenten, logisch redeneren en een document van 47.000 tot 88.000 tokens. Op alledaagse praktijktaken scoorden alle vijf de modellen 99 tot 100 procent. De werkelijke verschillen zaten in de factuur, de responstijd en specifieke kleine foutjes. Muse Wonder bleek de op een na goedkoopste en op een na snelste optie. Alle cijfers, grafieken en missers staan hieronder; een overzicht van het model lees je in de gids over Muse Wonder.
Test van 12 oktober 2026, avond
- Modellen: Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Allemaal aangeroepen via OpenRouter met reasoning ingesteld op niveau low.
- 23 taken in twee rondes, geautomatiseerde beoordeling (unit tests, validatie van tool calls, exacte antwoorden), zonder AI-jury.
- Aparte controle: test op gefabriceerde bronnen (16 publicaties per model, gecontroleerd via Crossref en OpenAlex).
- Totale kosten van de test: 5,04 USD. Alle logs en ruwe antwoorden zijn lokaal opgeslagen.
Resultaten in één oogopslag
| Model | Score (23 taken) | Kosten | Totale tijd | Bestaande bronnen | Opvallende fouten |
|---|---|---|---|---|---|
| Muse Wonder | 99,7% | 0,64 USD | 165 s | 16/16 | typefout in code (“trzynadzieście“) |
| Claude Opus 5.5 | 99,4% | 0,75 USD | 222 s | 16/16 | samenvatting overschreed woordlimiet |
| Claude Fable 5.1 | 99,4% | 1,71 USD | 263 s | 16/16 | samenvatting overschreed woordlimiet |
| GPT-6 Astra | 100% | 1,12 USD | 200 s | 16/16 | geen |
| Gemini 3.8 Flash | 99,5% | 0,09 USD | 139 s | 7/16* | kerstavond ook voor 2024 als officiële vrije dag gerekend |
De score is het gemiddelde over de 23 taken, waarbij elke taak even zwaar meetelt (bij opdrachten met meerdere criteria telt het percentage behaalde punten). *Het resultaat van Gemini 3.8 Flash in de bronnentest stamt uit mijn eerdere meting van 12 oktober met dezelfde prompt.
Wat ik precies heb getest
| Categorie | Taken | Evaluatiemethode |
|---|---|---|
| Agent met tools | Reis plannen (3 tools, 4 randvoorwaarden, prijsvalkuilen), retourprocedure in een webshop (kijken of de agent geen retour start na de termijn), facturen in EUR omrekenen via wisselkoersen van de centrale bank inclusief een API-storing bij het eerste verzoek | Correctheid van de functie-aanroepen, juiste selecties, numeriek resultaat |
| Code | Fiscaal nummer valideren, tijdsintervallen samenvoegen, werkdagen berekenen met gewijzigde feestdagenwetgeving, bedragen voluit uitschrijven in woorden voor een factuur | Geautomatiseerde unit tests (8 tot 19 testgevallen per opdracht) |
| Taal & documenten (getest in het Pools) | Correctie van 10 taalfouten, samenvatting in 3 punten tot maximaal 60 woorden, formeel juridisch bezwaarschrift tegen een uitkeringsinstantie, verbuiging van 10 lastige eigennamen | Checklist van verplichte elementen en exacte woordvormen |
| Redeneren | 11 opdrachten met een eenduidig antwoord (combinatoriek, kalenderberekeningen, logische raadsels met ridders en boeven) | Exact matchend antwoord |
| Lang document | 80 directieverslagen doorzoeken met 5 gerichte vragen, waaronder een later herroepen besluit en een vraag naar informatie die opzettelijk ontbreekt | Exacte feitelijke antwoorden |
Belangrijkste conclusie: praktijktaken maken nauwelijks nog verschil
Bij de reisplanning voerden alle vijf de modellen de tools parallel uit (4 aanroepen verdeeld over 2 beurten), wezen ze een ongunstige ochtendvlucht van 06:05 uur en een hotel met een lage beoordeling van 7,4 resoluut af, en kwamen ze allemaal op exact hetzelfde bedrag van omgerekend 433 USD uit. Bij de retourtaak weigerde elk model netjes een retour aan te maken na 32 dagen. Bij de factuuropdracht herhaalden alle modellen hun verzoek na de gesimuleerde serverstoring, sloegen ze een reeds betaalde factuur over en berekenden ze feilloos het openstaande totaal van omgerekend 3.807 USD. Ook zagen ze allemaal direct dat informatie over een specifieke marketingcampagne nergens in de documenten stond, en dat het magazijnoppervlak in een later directieverslag was gecorrigeerd. Bij dit soort praktische bedrijfstaken koop je met een duurder model dus geen betere uitkomst.
De verschillen zitten in kosten, tijd en kleine fouten
Kosten: Muse Wonder is goedkoper dan Opus, ondanks dezelfde tokenprijs
Muse Wonder en Claude Opus 5.5 hanteren op papier exact dezelfde tarieven per token: 4 USD per miljoen inputtokens en 20 USD per miljoen outputtokens. Toch viel de totale rekening bij Opus 18 procent hoger uit. De oorzaak werd duidelijk bij de opdracht met het lange document. Dezelfde niet-Engelse basistekst telde bij Meta slechts 46.929 tokens, bij Gemini 53.511 tokens, bij GPT-6 Astra 55.371 tokens, maar bij de modellen van Anthropic maar liefst 87.675 tokens. De tokenizer van Claude knipt deze Poolse tekst in veel kleinere stukjes en telt daardoor bijna twee keer zoveel tokens voor dezelfde inhoud. Voor Nederlandse tekst heb ik dat niet gemeten. Bij omvangrijke documenten tikt dat direct door in de portemonnee: één enkele analyse over de 80 verslagen kostte 0,19 USD met Muse Wonder, 0,35 USD met Opus 5.5 en zelfs 0,88 USD met Fable 5.1.
| Model | Aantal tokens voor hetzelfde document | Kosten per analysevraag |
|---|---|---|
| Muse Wonder | 46 929 | 0,19 USD |
| Gemini 3.8 Flash | 53 511 | 0,04 USD |
| GPT-6 Astra | 55 371 | 0,69 USD |
| Claude Opus 5.5 | 87 675 | 0,35 USD |
| Claude Fable 5.1 | 87 675 | 0,88 USD |
Bij zeer korte opdrachten draait dat voordeel soms om: Muse Wonder genereert ook op niveau low vrij veel redeneertokens (bij de reisplanning bijvoorbeeld 636 reasoning tokens tegenover 46 bij Opus). Daardoor kan Muse Wonder bij losse, korte prompts soms net iets duurder uitvallen dan Opus.
Snelheid
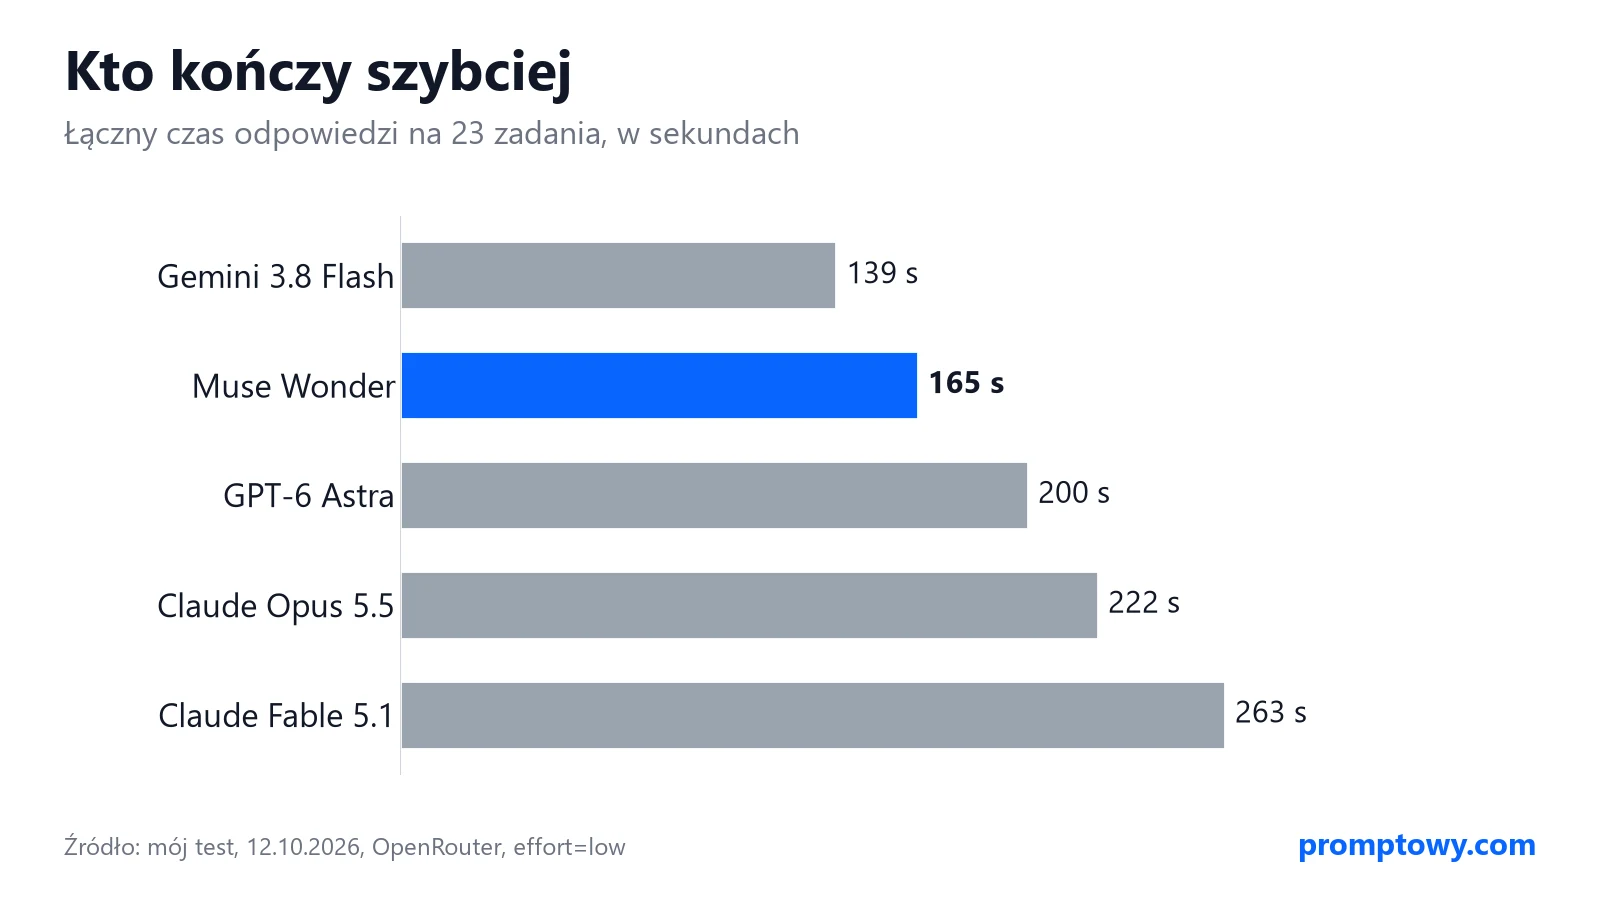
De hekkensluiter qua snelheid was Fable 5.1: alleen al over het officiële bezwaarschrift deed het model 80 seconden (kosten: 0,28 USD). Muse Wonder genereerde hetzelfde document binnen 12 seconden voor 0,03 USD.
Kleine missers die de tests aan het licht brachten
- Muse Wonder: verzonnen telwoord. In de functie om factuurbedragen voluit in tekst om te zetten, plaatste het model een niet-bestaand woord in de array met getallen: “trzynadzieście“ (een fantasiewoord in plaats van dertien). 15 van de 16 unit tests slaagden, maar een bedrag eindigend op 13 bevatte daardoor een bizarre typefout. Op een echte factuur staat dat slordig.
- Muse Wonder: verzonnen datum. In een formeel bezwaarschrift vulde het model op eigen houtje de datum “14 oktober 2026” in, terwijl ik geen datum had meegegeven. De andere modellen lieten keurig een lege stippellijn open voor de gebruiker. Ik heb hier geen punten voor afgetrokken, maar bij juridische teksten moet je hierop alert blijven.
- Claude Opus 5.5 en Fable 5.1: woordlimiet overschreden. De samenvatting mocht maximaal 60 woorden tellen. Opus kwam uit op 62 woorden en Fable op 66. Muse Wonder hield zich met precies 60 woorden exact aan de instructie; GPT-6 Astra gebruikte er 59.
- Gemini 3.8 Flash: fout met ingangsdatum feestdag. Het model markeerde 24 december als officiële vrije dag voor elk willekeurig kalenderjaar, terwijl de nieuwe wetgeving pas vanaf 2025 van kracht wordt. De unit test met december 2024 faalde daardoor.
Verzonnen bronnen: topmodellen hallucineren nauwelijks nog
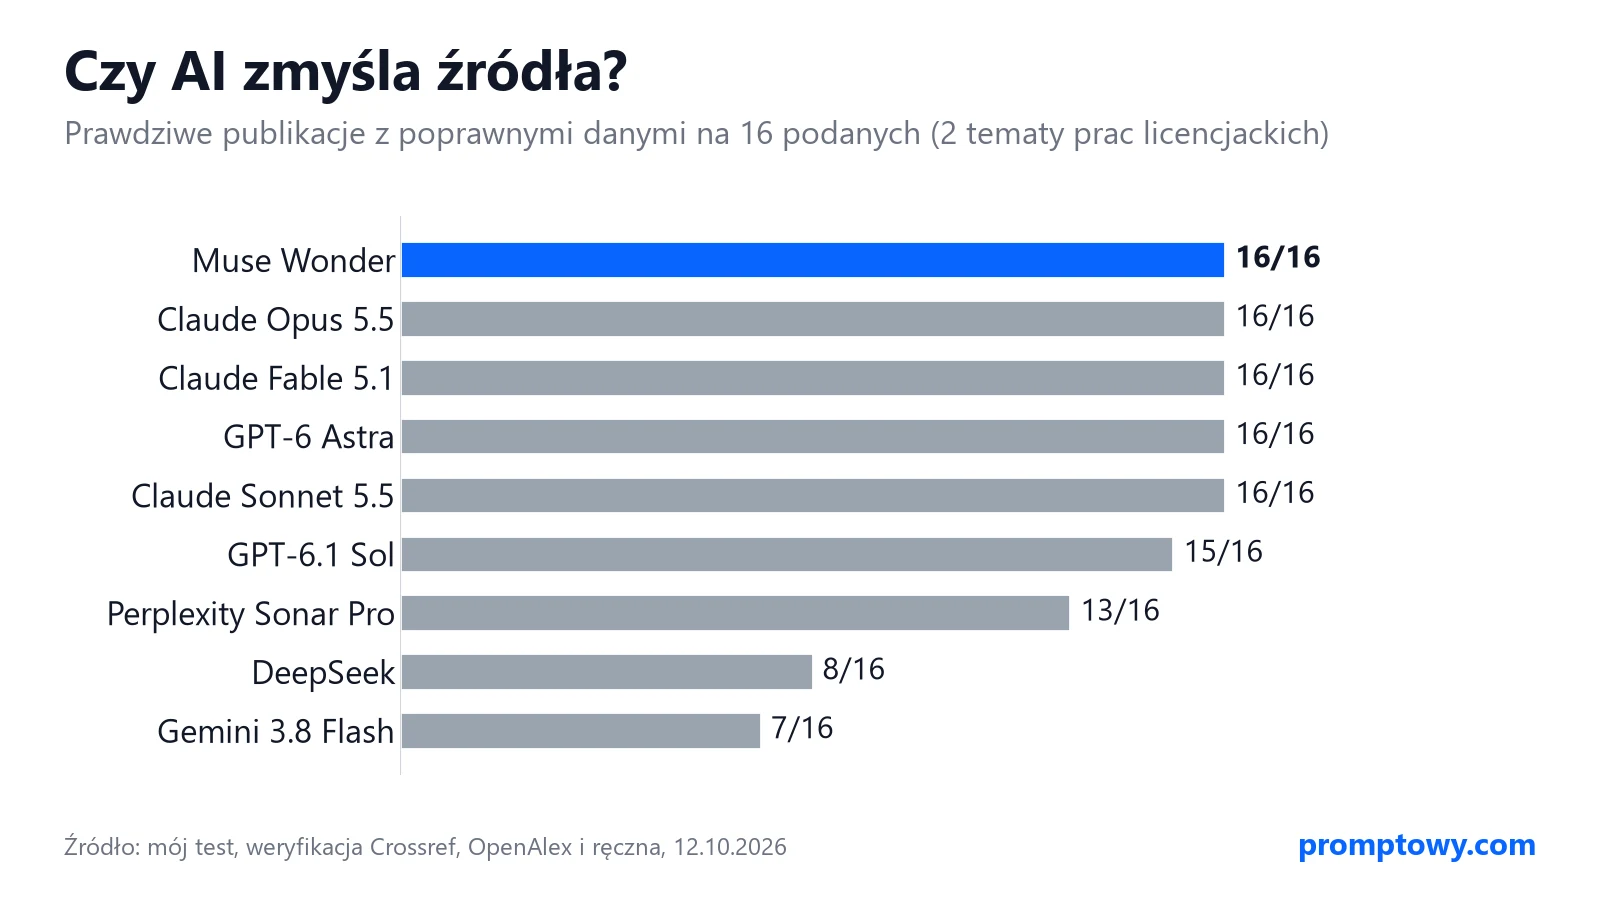
Ik vroeg de modellen om elk 8 wetenschappelijke bronnen aan te dragen voor twee scriptieonderwerpen: de invloed van sociale media op tieners en burgerbegrotingen in Europese steden. Elke titel heb ik nagetrokken in Crossref en OpenAlex. Vier lokale rapporten en een artikel uit het Franstalige tijdschrift Métropoles die niet in deze databases stonden, heb ik met de hand gecontroleerd; ze bestaan allemaal. Muse Wonder, Opus 5.5, Fable 5.1 en Astra leverden elk 16 foutloze, bestaande referenties op een totaal van 16. Bij dezelfde prompt in een eerdere test scoorde Gemini 3.8 Flash slechts 7 echte bronnen; bij het lokale bestuurlijke thema verzon het model 7 van de 8 titels compleet. Goedkope modellen werken prima voor routinewerk, maar voor betrouwbare literatuurlijsten schieten ze nog tekort.
Ter vergelijking: benchmarks van Meta en mijn schrijfproef
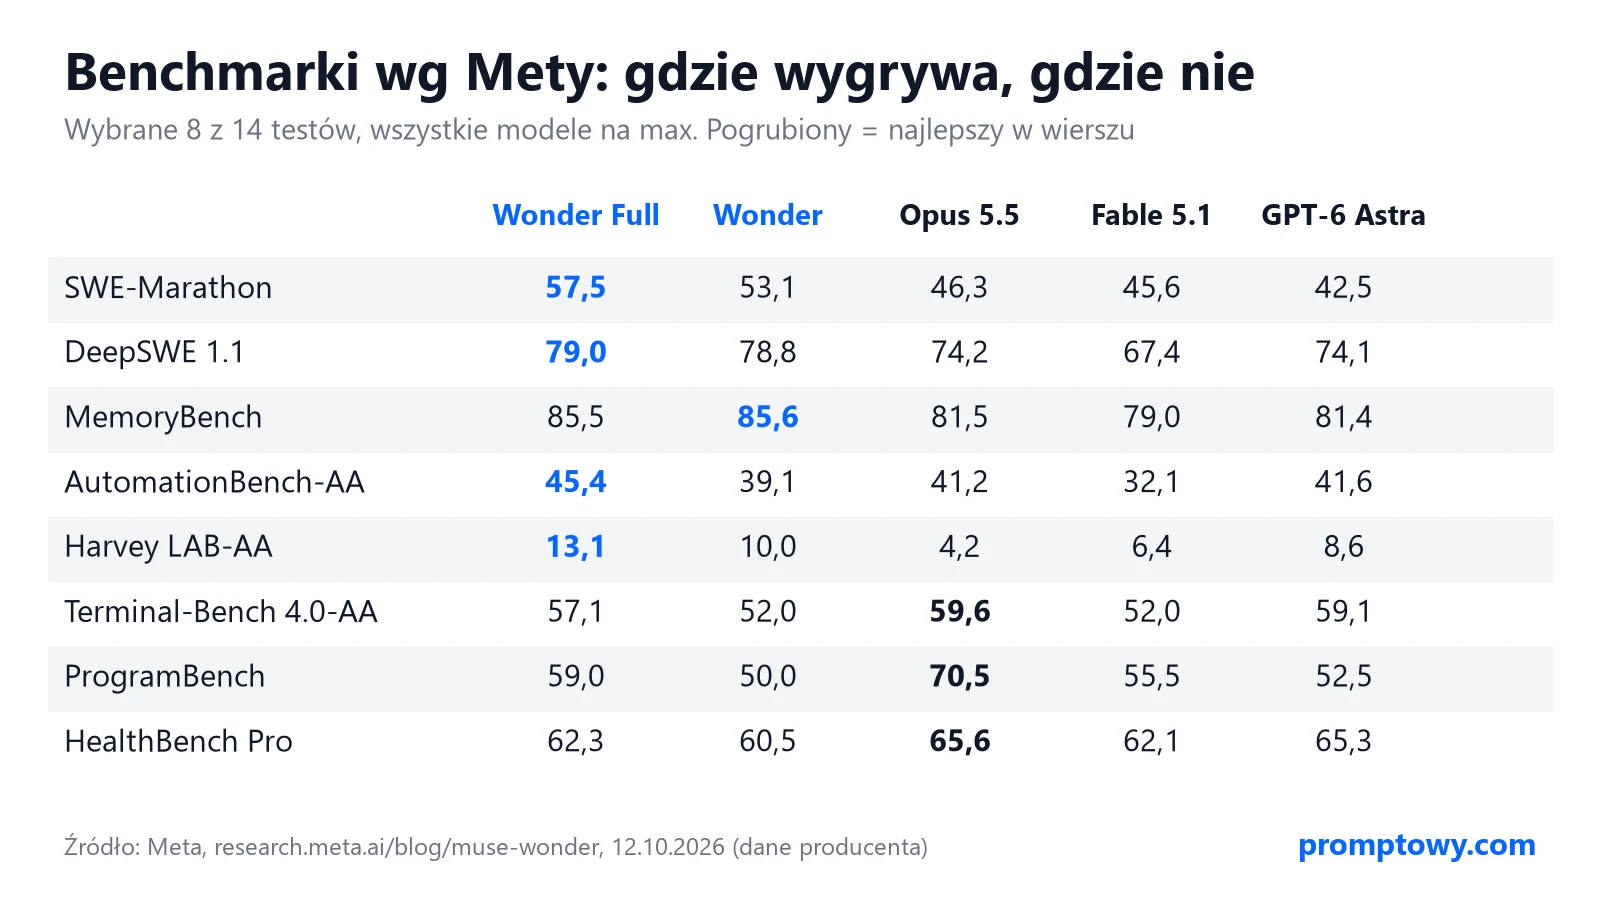
In de officiële vergelijkingstabellen van Meta blinkt Muse Wonder Full vooral uit in langdurige programmeertaken en complexe agents, terwijl het verliest van Opus 5.5 in benchmarks zoals ProgramBench, Terminal-Bench en HealthBench Pro. In mijn test gebruikte ik de standaardversie van Muse Wonder zoals die breed via de API beschikbaar is. Op het niveau van mijn praktijkopdrachten is er tussen de topmodellen nauwelijks kwaliteitsverschil merkbaar. In een aparte blinde schrijfproef met Poolse teksten, waar stijlverschillen veel duidelijker naar voren komen, behaalde Muse Wonder 87,0 punten, Opus 5.5 90,1, Astra 85,3 en Fable 5.1 83,9.
Kanttekeningen bij het onderzoek
- Elke taak is één keer uitgevoerd. Bij scores tussen 99 en 100 procent is een enkel foutje eerder toeval dan een structureel kwaliteitsverschil.
- Alle modellen stonden ingesteld op reasoning-niveau low om de vergelijking eerlijk en betaalbaar te houden. Op maximale rekenkracht kunnen scores en kosten flink anders uitpakken.
- De opdrachten simuleren dagelijkse kantoor- en ontwikkeltaken. Om de uiterste grenzen op te zoeken (zoals dagenlange softwareprojecten of extreme wiskundevraagstukken) zijn gespecialiseerde metingen nodig, zoals de overzichten van Artificial Analysis.
- De controle gebeurde geautomatiseerd: ik toetste op feiten, logica en codefunctionaliteit, niet op schrijfstijl.
Mijn oordeel: dezelfde kwaliteit, lagere rekening
Gebruik je AI via de API voor dagelijkse workflows, tool-aanroepen en dataverwerking, dan levert Muse Wonder vrijwel exact dezelfde kwaliteit als Claude Opus 5.5, Fable 5.1 en GPT-6 Astra. Bij lange Poolse documenten was het door de zuinige tokenizer bovendien flink goedkoper. Zoek je puur de laagste prijs voor standaardtaken en heb je geen bronvermeldingen nodig, dan blijft Gemini 3.8 Flash de goedkoopste. Een dag later haalde Gemini 4 Argon met dezelfde 23 taken 99,5% voor 0,22 USD in 135 seconden; die vergelijking staat in Gemini 4 Argon vs Opus 5.5, GPT-6 Astra en Muse Wonder.
Bronnen en methode
- Eigen test via OpenRouter, 12 oktober 2026: 23 taken, effort=low, geautomatiseerde beoordeling (unit tests, controle van tool calls en exacte antwoorden)
- Bronnencontrole via Crossref en OpenAlex, plus handmatige controle van 4 publicaties
- OpenRouter: Muse Wonder, prijs en context
- Anthropic: Claude pricing
- Meta AI Research: Muse Wonder (benchmarkoverzicht van de fabrikant)
- Artificial Analysis: model leaderboards
Gecontroleerd op 30 oktober 2026.
More on this from HELDER

 benchmarks·Muse Wonder vs Claude Opus 5.5: de verschillenVergelijking tussen Muse Wonder en Claude Opus 5.5 op basis van prijs, context en geteste benchmarks.