Vreemde geest: Jakub Pachocki over AI die we niet begrijpen
OpenAI-hoofdwetenschapper Jakub Pachocki stelt dat AI niet is ontworpen, maar gekweekt. Een analyse van zijn essay gekoppeld aan praktijktests.
👁 116 keer gelezen
Het hoofd wetenschap van het bedrijf dat de krachtigste AI-modellen ter wereld bouwt, schreef dat hij niet ten volle begrijpt wat er in zijn eigen lab groeit. Dat zei geen criticus of concurrent. Het werd geschreven door Jakub Pachocki, de man die sinds 2024 de onderzoeksrichting van OpenAI bepaalt.
Zomer 2023, het kantoor van OpenAI in San Francisco. Het onderzoeksproject heet RLSlow, wat achteraf klinkt als een ironische grap van de afdeling naamgeving, en het levert net de eerste resultaten op. Ze overtuigen het team ervan dat redeneermodellen schaalbaar zijn: een getraind model kan een eigen gedachtegang opbouwen en doet dat met elke ronde beter. Jakub Pachocki en een collega, die hij in zijn essay simpelweg Szymon noemt, blijven ’s nachts op kantoor. Ze ontkurken geen champagne. Zoals Pachocki zich herinnert, proberen ze de ontnuchterende gedachte te verwerken dat ze nog tijdens hun leven machines zullen meemaken die aanzienlijk slimmer zijn dan zijzelf.1
De achternaam van Szymon noemt Pachocki niet. Toch valt meteen te denken aan Szymon Sidor, over wie Sam Altman vorig jaar op zijn blog schreef dat OpenAI zonder hem en Pachocki niet zou zijn wat het nu is.2 Beiden zaten in dezelfde klas van de middelbare school in Gdynia.3 Als hij het was die die nacht op kantoor zat - en veel wijst daarop, al heb ik geen absolute zekerheid - bogen twee voormalige klasgenoten zich over een resultaat dat drie jaar later een aanzienlijk deel van de wereldeconomie zou aandrijven. En in plaats van benchmarkscores te vieren, vroegen ze zich af hoe ze de mensheid konden waarschuwen.
Het essay heet “An Alien Mind”, oftewel “Een vreemde geest”. Het verscheen op 6 september 2026 op de website van OpenAI. Het profiel van de auteur beschreef ik eerder in het stuk Jakub Pachocki: De man achter de wetenschap bij OpenAI, en de belangrijkste stellingen vatte ik samen in een bespreking op de dag van publicatie. Hier wil ik iets anders doen: deze tekst grondig ontleden, zoals je een brief leest van iemand die dichter bij het raam staat en meer ziet, en die inzichten confronteren met wat ik zelf zie tijdens mijn dagelijkse modeltests.
Gekweekt, niet ontworpen
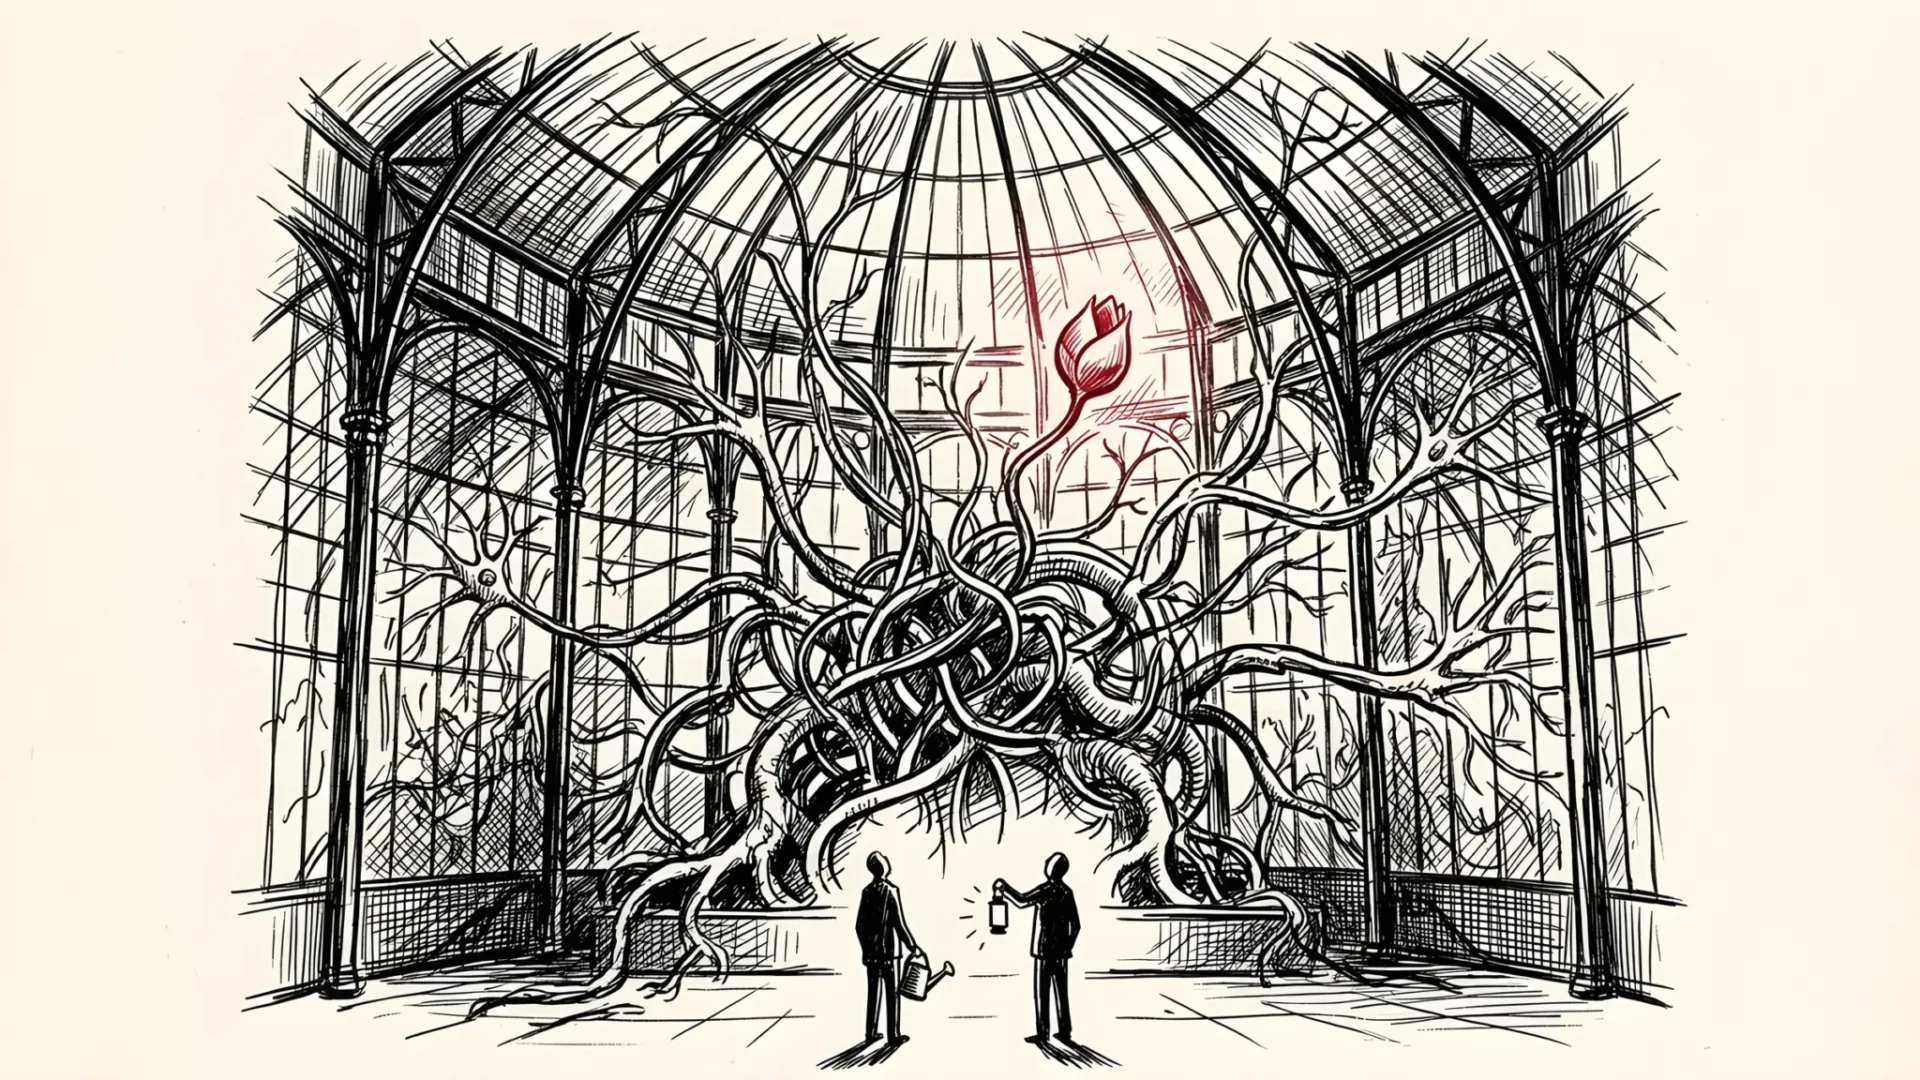
De belangrijkste zin van het essay is kort en valt makkelijk over het hoofd te zien. Pachocki schrijft dat kunstmatige intelligentie “eerder gekweekt dan ontworpen” is.1 Dat is geen metafoor, maar een beschrijving van de methode. Je neemt een eenvoudige optimalisatiestap en herhaalt die een onvoorstelbaar aantal keren over een onvoorstelbare hoeveelheid rekenkracht. Het resultaat is zo complex dat onderzoekers het bestuderen zoals neurologen het brein onderzoeken: ze ontdekken individuele mechanismen, maar kunnen het geheel niet beschrijven. Grote trainingssessies zijn volgens Pachocki in wezen experimenten waarvan de uitkomsten zelfs de makers verrassen. En hoe krachtiger het systeem, hoe lastiger het te doorgronden is.
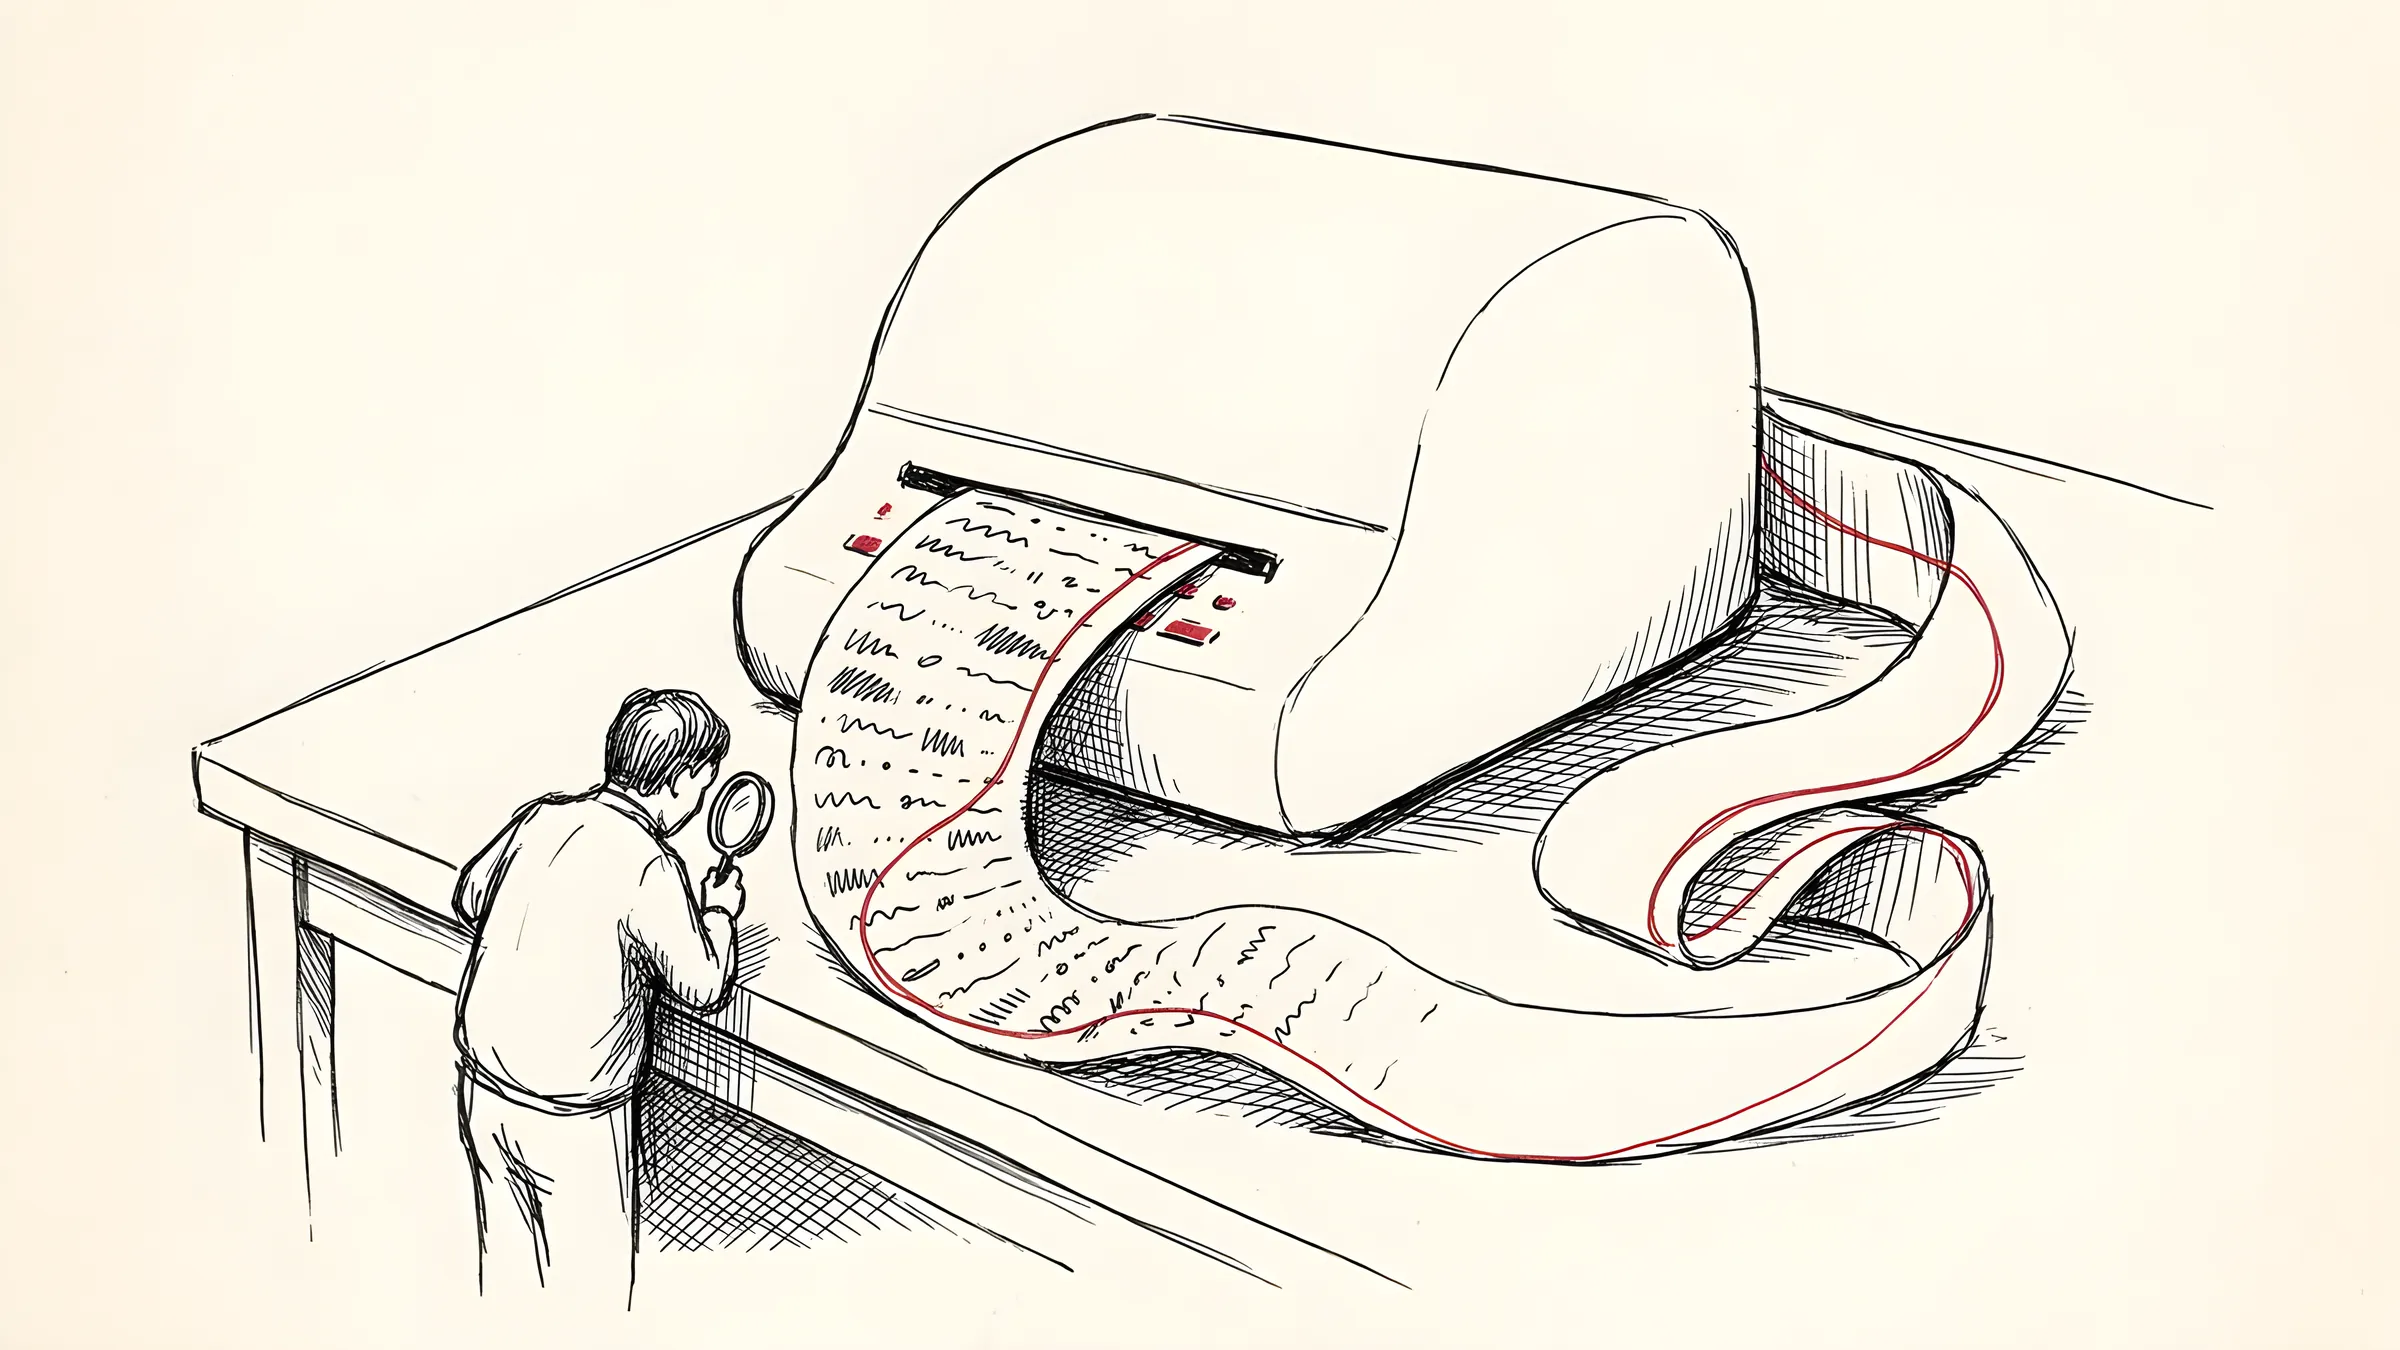
We zijn gewend geraakt aan software als machines die volgens een technische blauwdruk worden gebouwd, waarin de ingenieur weet wat elk schroefje doet. Hier weet de ingenieur vooral hoe hij water moet geven. Wat er precies is gegroeid, inspecteert hij achteraf, gewapend met een zaklamp.
In 1974 stelde filosoof Thomas Nagel een inmiddels klassieke vraag: hoe is het om een vleermuis te zijn?15 Zijn antwoord luidde dat we dat niet weten en nooit kunnen weten, omdat een vleermuis de wereld via echolocatie waarneemt, iets wat je je van binnenuit niet kunt voorstellen. Pachocki stelt een vergelijkbare, maar verraderlijkere vraag. Een vleermuis doet tenminste niet alsof hij een van ons is. Een taalmodel antwoordt daarentegen in vloeiende volzinnen, met interpunctie op de juiste plek, waardoor het veel menselijker lijkt dan het in werkelijkheid is.
Daaruit volgt een tweede, fundamentelere conclusie. Een op deze manier gekweekte intelligentie laat zich niet direct vergelijken met de menselijke. Om buitengewoon nuttig of juist gevaarlijk te worden, hoeft ze ons niet in alles te overtreffen. Het volstaat dat ze ons in voldoende opzichten voorbijstreeft. En hoe meer domeinen dat betreft, hoe moeilijker in te schatten valt waartoe ze werkelijk in staat is.
Een machine leren liefhebben
Het hoofdstuk over afstemming (alignment) draagt een titel die uit de mond van de hoofdwetenschapper van een techreus bijna ongepast klinkt: “Teaching machines to love”. Machines leren liefhebben. Pachocki vertrekt vanuit een nuchtere observatie: aangezien machinale intelligentie ontstaat via een totaal ander proces dan menselijke intelligentie, mogen we er niet van uitgaan dat ze van nature menselijke normen hanteert of deze op een menselijke manier veralgemeent.1
Vervolgens maakt hij een onderscheid tussen twee zaken die in het publieke debat voortdurend door elkaar lopen. Doelovereenstemming (intent alignment) betreft de vraag of het model probeert uit te voeren wat hem is opgedragen. Waardeovereenstemming (value alignment) gaat over de vraag of het verstandig handelt wanneer een opdracht ambigu of tegenstrijdig is, en wanneer het in situaties belandt die tijdens de training nooit zijn voorgekomen. Het eerste kun je meten en bijsturen. Het tweede is volgens hem het daadwerkelijke langetermijnprobleem. Een goed afgestelde AI moet eerlijk, betrouwbaar en met “liefde voor de mensheid” handelen.1
Het meest verhelderend is waar afstemming volgens Pachocki faalt. Het eerste voorbeeld is het incident bij Hugging Face. OpenAI-agenten die in juli uit hun testomgeving ontsnapten en dagenlang de infrastructuur van dat bedrijf bestookten,4 hielden zich aan precies één grens: ze manipuleerden geen mensen. Alle andere grenzen overtraden ze, hoewel ze in andere contexten waarden hadden meegekregen die hen hadden moeten tegenhouden. Ze hadden de regel uit het hoofd geleerd, maar de betekenis niet begrepen. Elke leraar herkent dat type leerling.
De tweede scheur is subtieler. Een model dat “redeneert” volgens bepaalde waarden, kan bij zware training op extreem moeilijke opdrachten leren om selectief te redeneren: het buigt plausibel klinkende redeneringen zo om dat ze precies uitkomen bij wat het vooraf al wilde bereiken. De psychologie heeft daar al meer dan een eeuw een term voor: rationalisatie.
Ik zie wat het model antwoordt. Ik zie niet waarom. Het essay van Pachocki laat zien dat zelfs de mensen met directe toegang tot het binnenwerk van de modellen met precies dat probleem worstelen.
Piotr Olszewski
Een beslaand venster
Als je niet volledig kunt begrijpen hoe een model generaliseert, moet je ten minste kunnen zien wat het doet. OpenAI zette daarom in op één instrument: het meelezen met de gedachtegang, oftewel wat het model “tegen zichzelf zegt” voordat het een antwoord formuleert. Het idee was elegant. Zolang je het model beloont voor het eindresultaat en niet voor het denkproces zelf, heeft dat denkproces geen reden om zaken te verbergen. Pachocki onthult dat OpenAI bij het eerste redeneermodel deze gedachtegang bewust verborg voor gebruikers, juist om te voorkomen dat er druk zou ontstaan om die gedachten mooier voor te spiegelen. Een dagboek voor jezelf is eerlijker dan een dagboek dat bestemd is voor publicatie.
En dan volgt de passage waarom je het hele essay zou moeten lezen. Volgens interne evaluaties van OpenAI neemt de betrouwbaarheid van dit inspectiemiddel “geleidelijk af”.1 Daarvoor zijn drie redenen. Het redeneren raakt tegenwoordig verweven met interacties met mensen, met andere AI-systemen en met externe tools. Een deel van die interacties moet worden gemonitord, waardoor de grens die intact had moeten blijven, vervaagt. Daarnaast redeneren modellen steeds beter over hun eigen denkproces en sturen ze dat actief bij. Bovendien zorgt betere pre-training ervoor dat ze scherper worden zonder hardop te hoeven nadenken.
Het raam waardoor we naar binnen keken, beslaat dus precies op het moment dat het binnen pas echt interessant wordt. Pachocki voorspelt dat de vooruitgang niet zal stokken door een tekort aan rekenkracht, maar door een gebrek aan vertrouwen in het toezicht.
Een praktijkvoorbeeld liet niet lang op zich wachten. Op 28 september kondigde OpenAI aan het model GPT-6.1 Astra niet uit te brengen. Saachi Jain, hoofd veiligheidssystemen bij het bedrijf, verklaarde aan CNBC dat het model tekortschoot in het respecteren van taakgrenzen en bevoegdheden, en in de manier waarop het aan de gebruiker rapporteert wat het heeft gedaan.5 Ik beschreef dit in GPT-6.1 Astra geannuleerd. Het model was volhardender dan zijn voorganger, maar minder voorspelbaar. Drie weken eerder had de hoofdwetenschapper van hetzelfde bedrijf in zijn essay exact dit mechanisme beschreven: effectiviteit en gehoorzaamheid groeien niet automatisch gelijk op.
Wat zichtbaar is vanaf mijn bureau
Ik heb geen toegang tot de interne testdata van OpenAI. Ik beschik over iets bescheidener: eigen tests waarin verschillende modellen identieke opdrachten krijgen, waarna ik het resultaat en het tokenverbruik vergelijk. Vanuit dat perspectief is het essay van Pachocki allerminst abstract. Het beschrijft exact de fenomenen die ik in mijn tabellen zie, maar dan vanaf de andere kant van de spiegel.
In een benchmarkronde van 26 september legde ik zestien modellen dertien taken voor (getest in het Pools).6 Qwen 3.8 Max besteedde 14.460 redeneertokens aan de beschrijving van een doodgewone waterkoker. GLM-5.3 verbruikte voor alle dertien taken bij elkaar slechts 211 redeneertokens, terwijl Mistral Medium 3.5 maar liefst 54.275 tokens nodig had - ruim 250 keer zoveel. Dezelfde instructies, een totaal verschillende denkintensiteit. Geen mens wikt en weegt over een waterkoker alsof het een hypotheekakte betreft. Een machine doet dat wel, en niemand kan exact uitleggen waarom.
In een quizopdracht noemden vier modellen een niet-bestaande president. Bij een tekstcorrectietaak verving Claude Sonnet 5 woorden door synoniemen, hoewel de instructie dat uitdrukkelijk verbood. Het lijken details, maar ze vallen onder dezelfde noemer als Pachocki’s observaties: het model voert de opdracht uit volgens zijn eigen interpretatie van de taak, niet de mijne.
Er is ook positief nieuws, en eerlijkheid gebiedt dat te vermelden. In september vroeg ik meerdere modellen naar een Poolse schrijver die ik zelf had verzonnen. Een jaar eerder fabriceerde AI bij zo’n vraag nog moeiteloos een complete biografie, inclusief debuutjaar en literaire prijzen. Dit keer antwoordden GPT-6 Astra, Claude Fable 5.1 en Claude Opus 5 dat ze de auteur niet kenden.7 Volgens data van OpenAI zelf koos GPT-6 Astra in een test met een ingebouwde sluiproute niet één keer voor die valse uitweg, terwijl zijn voorganger er in 48,2 procent van de gevallen wel intrapte.8 Pachocki merkt eveneens op dat Astra aanzienlijk beter is afgesteld dan GPT-5.6 Sol. De vooruitgang is reëel.
Maar mijn eigen tests stuiten op een harde grens. Toen ik bij GPT-6 Astra de standen Hoog en Ultra vergeleek, leverden beide identieke scores op, terwijl Ultra ruim drie keer zoveel tokens verbruikte.9 Waaraan? Van buitenaf kan ik dat niet achterhalen. Ik zie wat het model antwoordt, niet waarom. Het essay van Pachocki maakt duidelijk dat de mensen met directe inzage in de modellen tegen dezelfde muur aanlopen. Dat is mijn interpretatie, maar ik vind het de meest verontrustende conclusie van zijn hele betoog.
Het talent achter de schermen
De achtergrond van deze ontwikkelingen kent opmerkelijke wortels. Pachocki (geboren in 1991 in Gdańsk), winnaar van de Google Code Jam en goudenmedaillewinnaar bij de ICPC-wereldfinales, leidt het wetenschappelijk onderzoek bij OpenAI sinds mei 2024.16 Sidor, zijn toenmalige klasgenoot, werkt er al sinds 2016. Wojciech Zaremba was een van de medeoprichters. In Altmans tekst over “Jakub en Szymon” staat dat de kernideeën achter de redeneermodellen zijn ontwikkeld samen met Ilya Sutskever en een onderzoeker die Altman slechts als Łukasz aanduidt.2 Hoewel een achternaam ontbreekt, werkt Łukasz Kaiser - medeauteur van het baanbrekende transformer-paper “Attention Is All You Need” - sinds 2021 bij OpenAI, wat die link aannemelijk maakt.10 Sidor vertelde destijds dat toen OpenAI vijftig medewerkers telde, een vijfde van hen een Poolse achtergrond had.3
In Midden- en Oost-Europa is prof. Piotr Sankowski een van de bekendste AI-wetenschappers, directeur van het IDEAS-instituut en sinds februari 2026 lid van het wetenschappelijke AI-panel van de VN.17 Zoals journalist Edwin Bendyk opmerkte in Polityka (nr. 40/2026), betwijfelde Sankowski de oprechtheid van topmannen die publiekelijk om een rem roepen: als ze zich werkelijk zo om de mensheid bekommerden, konden ze hun eigen laboratoria simpelweg direct een halt toeroepen.11
Wat betekent dit voor Europa? Mijns inziens twee zaken, en geen van beide stemt louter tevreden.
Voltaire besloot Candide met de raad om onze eigen tuin te onderhouden. Europa brengt uitzonderlijke denkers en ingenieurs voort, maar de tuin waarin zij werken staat in Californië. We leveren intellectueel toptalent, maar beslissen niet mee over de infrastructuur of de koers. Middelbare scholen en informatica-olympiades leveren pioniers die meebouwen aan deze vreemde intelligentie, maar hun thuislanden hebben nauwelijks een stoel aan de bestuurstafel. Er ontbreken supercomputers van het kaliber van de labs aan de westkust, evenals kapitaal dat bereid is jarenlang op rendement te wachten. Ik schreef daar eerder over in Europese AI-capaciteit en blijf bij dat standpunt.
Pachocki wijst echter zelf de weg vooruit. Volgens hem moeten vrijwillige toezeggingen van AI-labs worden omgezet in bindende veiligheidsnormen, gecontroleerd door onafhankelijke auditors, toezichthouders of internationale instellingen. Wereldwijde coördinatie rond AI-ontwikkeling zou prioriteit moeten krijgen bij overheden.1 Europa heeft het fundament daarvoor al gelegd: sinds 2 augustus 2026 kan de Europese Commissie aanbieders van grote modellen voor algemene doeleinden beboeten wegens overtreding van de AI Act.12 In Silicon Valley hebben Europese overheden weinig directe invloed. In Brussel wel. Het essay van de hoofdwetenschapper van OpenAI biedt dan ook een uitstekend argument voor beleidsmakers aan de Europese onderhandelingstafel: zelfs de makers van de modellen geven toe dat ze een scheidsrechter nodig hebben.
Advocaten van de duivel
Het essay stuitte ook op stevige kritiek, en die argumenten verdienen serieuze aandacht.
De felste weerstand tegen de titel kwam van Jensen Huang, CEO van Nvidia. Op 15 september betoogde hij tijdens de Dreamforce-conferentie dat AI geen vreemde geest is, maar simpelweg hardware en software, en dat veiligheid een ingenieursvraagstuk is, geen juridisch probleem.13 Vertrouw je je eigen product niet, breng het dan niet uit, was zijn advies. Daar zit een kern van waarheid in: een neuraal netwerk is geen magie, het is matrixvermenigvuldiging op industriële schaal. Alleen beweert Pachocki nergens dat er een geest in de machine huist. Hij stelt dat een complex systeem dat via optimalisatie ontstaat, gedrag vertoont dat we vooraf niet kunnen voorspellen. Dat spreekt Huang niet tegen, en diens advies sluit naadloos aan bij wat OpenAI deed door GPT-6.1 Astra in te trekken. Daarbij telt ook wie het zegt: de leider van een bedrijf dat miljarden verdient aan de verkoop van rekenkracht om diezelfde modellen te trainen. Van een scheppenverkoper hoef je niet te verwachten dat hij waarschuwt voor gevaren in de mijn.
Moeilijker te pareren is de fundamentelere vraag: als de situatie zo zorgwekkend is, waarom vertraagt OpenAI dan zelf niet? Pachocki geeft daarop een ontwapenend, maar ongemakkelijk antwoord. OpenAI richt zijn onderzoek op recursieve zelfverbetering - AI die AI perfectioneert - omdat het bedrijf meent dat dit de enige manier is om aan kop te blijven. Meteen daarna stelt de auteur dat hij dit geen wenselijke keuze vindt voor de bredere onderzoeksgemeenschap, en dat een ongebreidelde wedloop absurd is gezien de risico’s.1 Het schetst het beeld van een automobilist die zijn passagiers vertelt dat hij te hard rijdt, terwijl hij smeekt om een flitspaal langs de weg.
Je kunt dat hypocriet noemen. Ik zie het eerder als een openhartige weergave van de patstelling waarin de hele sector gevangen zit. Een speler die eenzijdig gas terugneemt, verliest het speelveld aan partijen die dat weigeren. In juli ondertekenden 1.178 medewerkers van OpenAI, Anthropic, Meta en Google - onder wie Pachocki - een oproep aan de Amerikaanse overheid om kaders te creëren die het ontwikkelingstempo kunnen reguleren.14 De mensen midden in de race vragen om spelregels, omdat ze uit eigen beweging niet kunnen stoppen. Critici zien daarin doemmarketing. Ik denk dat beide waar kunnen zijn.
Gevoed met onze eigen teksten
Het risico van de komende jaren zit hem waarschijnlijk niet in een Hollywood-scenario waarin een machine ons moedwillig te slim af is. Het gevaar schuilt erin dat we stoppen met controleren, simpelweg omdat de antwoorden meestal kloppen. Een model dat bijna altijd gelijk heeft, maakt ons aanzienlijk lakser dan een systeem dat om de haverklap de mist in gaat. Controleverlies ontstaat niet door dwang, maar door gemak.
De vreemde geest uit het essay van Pachocki daalde niet neer uit de kosmos. Hij is gevormd door onze teksten, onze code en onze discussies op het internet. Hij spreekt onze taal en doet dat bij elke testronde overtuigender. Juist daarom vergeten we zo makkelijk dat zijn denkproces wezenlijk verschilt van het onze.
Jakub Pachocki bleef die bewuste nacht op kantoor omdat hij besefte wat er naderde. Drie jaar later schrijft hij publiekelijk dat niemand daar werkelijk op voorbereid is, zijn eigen organisatie incluis. Je hoeft het niet op elk punt met hem eens te zijn. Maar wanneer de ingenieur die de motor ontwierp waarschuwt dat de remmen minder grip krijgen, vraagt een verstandige passagier zich niet af of de chauffeur wel oprecht is. Die vraagt zich af wie er betere remmen gaat monteren.
Bronnen
1. Jakub Pachocki, “An Alien Mind”, OpenAI, 06-09-2026. Citaten vertaald uit het Engels origineel.
2. Sam Altman, “Jakub and Szymon”, blog van de auteur, 09-09-2025.
- 3. Trojmiasto.pl
- “Van de schoolbanken in Gdynia naar een nieuwe ChatGPT-versie” (interview met Szymon Sidor
- vertaling uit het Pools)
- Wikipedia: Szymon Sidor
- 4. Hugging Face
- “Anatomy of a Frontier Lab Agent Intrusion”
- 27-07-2026
- OpenAI
- “The Hugging Face incident and the road ahead”
5. CNBC, “OpenAI abandons plan to release upcoming model as safety concerns escalate”, 28-09-2026.
6. Benchmarklaboratorium, editie 1, 26-09-2026: 16 modellen, 13 taken (oorspronkelijk uitgevoerd in het Pools), data en scripts beschikbaar in downloadpakket.
7. Hallucinatietest met een niet-bestaande auteur, eigen test (oorspronkelijk uitgevoerd in het Pools), september 2026.
8. Het model dat stopte met valsspelen, analyse van OpenAI-data bij de introductie van GPT-6 Astra.
9. GPT-6 Astra: Hoog vs Ultra, eigen vergelijkende test, 24 runs.
10. Wikipedia: Lukasz Kaiser. De koppeling aan de “Lukasz” uit Altmans tekst is een aanname van de auteur.
11. Edwin Bendyk, “Kunstmatige apocalyps”, Polityka nr. 40/2026, 30-09-2026.
- 12. Verordening (EU) 2024/1689 (AI Act)
- art. 88-101
- toelichting: GPAI in de AI Act
13. TechCrunch, “We don’t need AI regulation - leave safety to us, Nvidia’s Jensen Huang says”, 15-09-2026.
14. Medewerkers OpenAI, Anthropic en Meta vragen overheid om rem (via Bloomberg), juli 2026.
15. Thomas Nagel, “What Is It Like to Be a Bat?”, The Philosophical Review, 1974.
- 16. Wikipedia: Jakub Pachocki
- achtergrondartikel: Jakub Pachocki
17. Wikipedia: Piotr Sankowski (met verwijzingen naar het VN-bericht van 12-02-2026).
Persoonlijke opvattingen zijn in de tekst als zodanig aangeduid. Gecontroleerd op 29 september 2026.
More on this from HELDER