Token-taks 2026: Poolse tekst kost bij Claude 56% meer dan OpenAI
Dezelfde Poolse tekst telt 2466 tokens bij GPT-6 Astra, maar 3859 bij Claude Fable 5.1. Meting op acht modellen en wat dat betekent voor je API-rekening.
Update (9 november 2026): Claude Fable 5.2 en Mythos 5.2 zijn uit - prijzen, toegang en benchmarks in mijn gids over Claude Fable 5.2.
👁 121 keer gelezen
De prijslijst van een model vertelt je wat een miljoen tokens kost. Niet hoeveel tokens jouw tekst opslokt, en dat hangt af van hoe het model Poolse tekst in stukjes verdeelt. We testten dit op de simpelst mogelijke manier: hetzelfde fragment Poolse tekst, 7843 tekens en ongeveer 1350 woorden, stuurden we naar acht modellen met een limiet van één token output en lazen af hoeveel input-tokens elk model telde. Kosten van de hele test: een paar cent.
| Model | Tokens voor dezelfde tekst | Tekens per token | Ten opzichte van GPT-6 Astra |
|---|---|---|---|
| GPT-6 Astra | 2 466 | 3,18 | 0 % |
| GPT-5.6 Sol | 2 466 | 3,18 | 0 % |
| Grok 4.6 | 2 489 | 3,15 | +1 % |
| DeepSeek V4 Pro | 2 599 | 3,02 | +5 % |
| Kimi K3 | 3 355 | 2,34 | +36 % |
| Claude Sonnet 5 | 3 857 | 2,03 | +56 % |
| Claude Fable 5.1 | 3 859 | 2,03 | +56 % |
| Gemini 3.8 Flash | geen data: bij limiet van één token gaf de API geen usage-informatie terug | ||
Twee kampen tokenizers
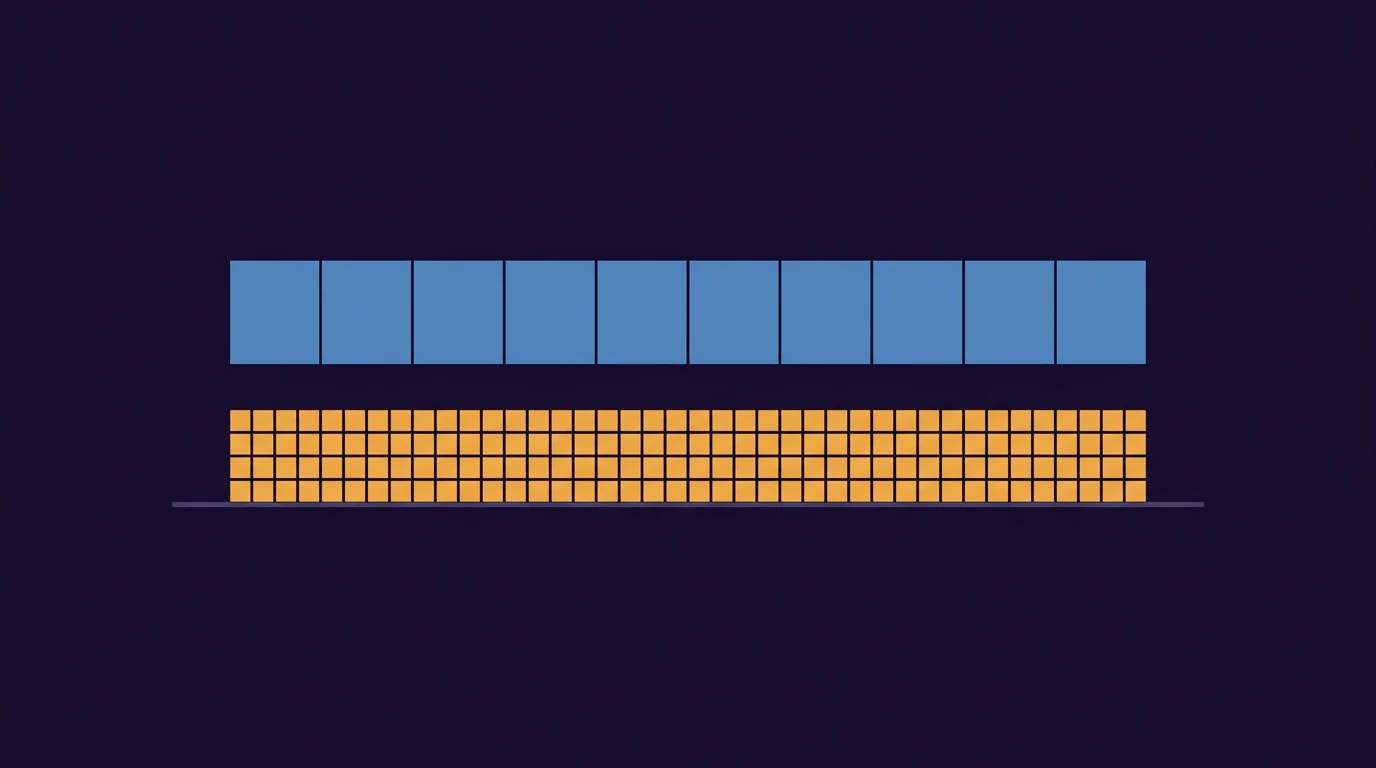
De resultaten vallen uiteen in twee groepen. Modellen van OpenAI, xAI en DeepSeek passen ongeveer 3,1 tekens Poolse tekst in één token. Modellen van Anthropic en Kimi verdelen dichter: Claude heeft voor dezelfde tekst 56 procent meer tokens nodig, Kimi 36 procent. Beide OpenAI-modellen gaven een identiek resultaat, wat bevestigt dat Astra dezelfde tokenizer gebruikt als de 5.6-lijn.
Voor Engels zijn deze verschillen kleiner, omdat alle tokenizers daar het meest uitgebreid op getraind zijn. Pools, met verbuigingen en diakritische tekens, is voor een deel van hen een tweederangstaal, en je betaalt daarvoor bij elke query.
Wat dit betekent voor je rekening
GPT-6 Astra en Claude Fable 5.1 hebben een identieke prijslijst: 10 dollar per miljoen input-tokens. Maar voor dezelfde Poolse tekst telt Claude 3859 tokens, Astra 2466. Bij hetzelfde tarief kost input voor Fable in de praktijk 56 procent meer. Bij één enkele query gaat het om fracties van een cent; bij duizend lange documenten per maand is het een verschil dat je op de factuur ziet.
Het werkt ook andersom, in het voordeel van goedkopere modellen. Claude Sonnet 5 kost 2 dollar per miljoen input-tokens, vijf keer minder dan Astra, maar door de dichtere tokenizer daalt het echte prijsvoordeel op Poolse tekst van vijfvoudig naar ongeveer drievoudig. Prijslijsten vergelijken leidt tot verkeerde conclusies als je de tokenizer niet meeneemt.
Google · Jouw bronnenHoger in Google - met één klikToevoegen aan voorkeursbronnen →Hoe je dit zelf meet
Je hoeft niets te raden. Stuur gewoon je typische document naar het model met een limiet van één token output en lees het aantal input-tokens af uit de usage-informatie. De kosten van zo’n meting zijn een fractie van een cent, en het resultaat zegt meer over je rekening dan een prijstabel.
Eén kanttekening: we hebben één fragment van één tekst gemeten. De verhoudingen tussen tokenizers zijn stabiel, omdat ze voortkomen uit hun constructie, maar de exacte getallen voor jouw documenten kunnen iets afwijken, vooral bij teksten met veel code, cijfers of eigennamen.
More on this from HELDER

 benchmarks·GPT-6 Astra voor programmeurs: wat codetests wel en niet zeggenTerminal-Bench, DeepSWE, FrontierCode: de volledige resultaten van GPT-6 Astra in programmeertests naast Claude Fable 5.1 en Opus 5, met conclusies.