Artificial Analysis beoordeelt beslissingsmodellen: Jev 1.13 op 1
De Artificial Analysis Decision Index v1.0 vergelijkt beslissingsmodellen. Jev 1.13 leidt, terwijl Decider v1.1 de goedkoopste optie is. Bekijk alle resultaten.
👁 117 keer gelezen
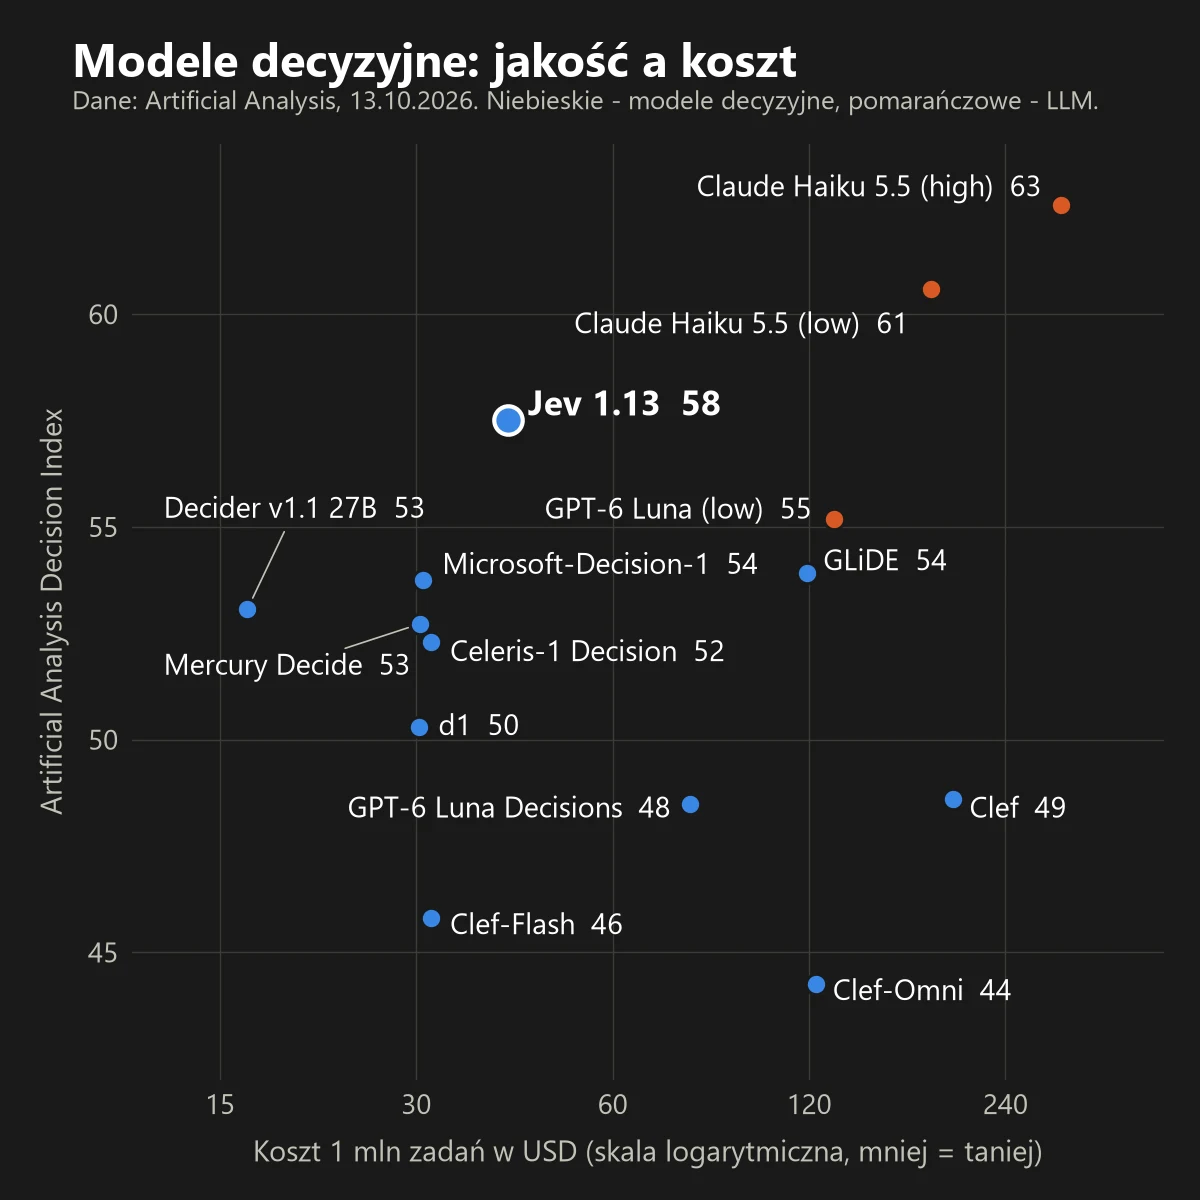
Op 13 oktober 2026 publiceerde Artificial Analysis de Decision Index v1.0, de eerste onafhankelijke vergelijking van AI-modellen die geen lopende tekst produceren, maar puur een optie uit een vaste lijst selecteren en de waarschijnlijkheid per keuze teruggeven. Jev 1.13 van TypeSafe voert de lijst aan met 58 punten, gevolgd door GLiDE (Fastino) en Microsoft-Decision-1 (beide 54 punten). De voordeligste optie is Decider v1.1 27B van Perplexity: circa € 15,19 (17 USD) per miljoen taken. Regulier model Claude Haiku 5.5 haalt weliswaar een hogere score (61), maar is volgens metingen van AA 11 keer trager en 4,4 keer duurder dan de koploper.
Belangrijkste cijfers (Artificial Analysis, 13-10-2026)
- 11 beslissingsmodellen in de index, waarvan 9 in het openingsartikel.
- Koploper: Jev 1.13 (TypeSafe) - 58 punten, circa € 37,54 (42 USD) per miljoen taken, 0,13 s per taak.
- Kosten per miljoen taken: van circa € 15,19 (17 USD, Decider v1.1 27B) tot circa € 177,87 (199 USD, Cloudflare Clef).
- Taakduur: van 0,06 s (Celeris-1 Decision) tot 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low): 61 punten, circa € 164,46 (184 USD) per miljoen taken, 1,4 s per taak.
Verantwoording: ik ken het Jev-model uit eerder eigen onderzoek; in september schreef ik er een eenvoudige API-client voor, bedoeld voor eigen redactionele tools. TypeSafe heeft deze tekst niet aangevraagd noch betaald. De positie van Jev beschrijf ik uitsluitend op basis van de onafhankelijke metingen van Artificial Analysis.
Omrekening op basis van de ECB-referentiekoers van 13-10-2026 (1 EUR = 1,1188 USD), bron: ECB.
Wat is een beslissingsmodel?
Een beslissingsmodel ontvangt twee zaken: de huidige status (bijvoorbeeld de tekst van een helpdeskticket) en een reeks vragen met gesloten antwoordopties. In plaats van een volzin te schrijven, levert het model voor elke toegestane optie een waarschijnlijkheid op. Artificial Analysis illustreert dit aan de hand van het ticket “uitbetalingen werken al 3 dagen niet en morgen moet ik de huur betalen”, gecombineerd met drie gelijktijdige vragen (vertaald uit het testmateriaal):
- naar welke afdeling - betalingen, techniek of account (keuze uit lijst),
- is het dringend - ja of nee,
- hoe gefrustreerd is de klant - rustig, gefrustreerd, boos (schaalverdeling).
Het beslissingsmodel beantwoordt alle drie de vragen in één enkele API-aanroep en toont direct de waarschijnlijkheidsverdeling. Een standaard LLM moet daarentegen een JSON-structuur genereren die je applicatiecode vervolgens moet parsen, zonder dat je een betrouwbaar getal krijgt over hoe zeker het model van zijn zaak is. Een uitgebreidere toelichting, inclusief een test die we in het Pools hebben uitgevoerd op Poolse tickets, vind je in de gids Beslissingsmodellen in AI.
Ranglijst: Artificial Analysis Decision Index v1.0
| Model (organisatie) | Index | Kosten per 1 mln taken | Taakduur |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | ca. € 37,54 (42 USD) | 0,13 s |
| GLiDE (Fastino Labs) | 54 | ca. € 106,36 (119 USD) | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | ca. € 27,71 (31 USD) | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | ca. € 15,19 (17 USD) | 0,17 s |
| Mercury Decide (Inception) | 53 | ca. € 26,81 (30 USD) | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | ca. € 28,60 (32 USD) | 0,06 s |
| d1 (Liquid AI) | 50 | ca. € 26,81 (30 USD) | 0,30 s |
| Clef (Cloudflare) | 49 | ca. € 177,87 (199 USD) | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | ca. € 70,61 (79 USD) | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | ca. € 28,60 (32 USD) | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | ca. € 109,94 (123 USD) | 0,17 s |
Ter vergelijking presteren algemene taalmodellen op dezelfde proeven als volgt: Claude Haiku 5.5 (low) noteert 61 punten tegen circa € 164,46 (184 USD) en 1,4 s, terwijl GPT-6 Luna (low) uitkomt op 55 punten tegen circa € 117,09 (131 USD) en 1,5 s. De vermelde tijd betreft de mediaan per taak; de kosten weerspiegelen de gemiddelde kosten op basis van actuele tokenprijzen, vermenigvuldigd met één miljoen. Beslissingsmodellen rekenen uitsluitend inputtokens af, terwijl generatieve taalmodellen zowel invoer als uitvoer factureren.
Hoe wordt de score berekend?
De Decision Index is een gewogen gemiddelde van vier afzonderlijke evaluaties, die elk voor 25% meetellen:
- AA-Omniscience-Decision (feitenkennis en hallucinaties) - 500 niet-openbare vragen met vijf opties: vier inhoudelijke antwoorden en de optie “weet ik niet”. De helft van het cijfer meet de nauwkeurigheid, de andere helft kijkt naar het percentage situaties waarin het model voor “weet ik niet” kiest in plaats van te gokken.
- HLE-MultiChoice (redeneervermogen) - 513 tekstuele meerkeuzevragen afkomstig uit Humanity’s Last Exam, een van de meest veeleisende benchmarks voor AI.
- When2Call (gereedschapsgebruik) - een test van NVIDIA: het model analyseert een dialoog en een reeks beschikbare tools en bepaalt zelfstandig of het direct antwoordt, een tool aanroept, om ontbrekende invoer vraagt of aangeeft dat de taak onhaalbaar is.
- WildGuardTest (classificatie en veiligheid) - een testset van Ai2: evalueert of een gebruikersverzoek schadelijk is, of het assistentantwoord een weigering betreft en of dat antwoord zelf schadelijk is.
Wat laten de testresultaten zien?
- Jev blinkt uit in logisch redeneren. In HLE-MultiChoice scoort het model 21 punten, terwijl geen enkel ander beslissingsmodel boven de 15 uitkomt. Op pure feitenkennis blijft de accuratesse steken op 35% (het beste model hierin is d1 van Liquid AI met 41%).
- Microsoft-Decision-1 erkent het vaakst eigen onwetendheid. Dit model kiest in 40% van de gevallen netjes voor “weet ik niet” (Jev haalt 35%, Mercury Decide 32%, de rest blijft onder de 17%). Model d1 heeft weliswaar de hoogste accuratesse qua kennis, maar geeft vrijwel nooit toe iets niet te weten (score 2).
- Bij het selecteren van tools overtreffen beslissingsmodellen reguliere LLM’s ruimschoots. Binnen When2Call noteren Celeris-1 Decision en GLiDE beiden 84 punten, tegenover 73 voor Claude Haiku 5.5 (low) en 77 voor GPT-6 Luna (low).
- Ook in classificatie zijn ze sterker. In de WildGuardTest behaalt GLiDE 95 punten, Jev en Decider beiden 94, terwijl Claude Haiku 5.5 (low) 93 en GPT-6 Luna (low) 89 punten halen.
- Alle beslissingsmodellen vertonen overmoedig gedrag. AA toetste de gerapporteerde waarschijnlijkheden aan de werkelijke accuratesse: bij feitelijke kennis en abstract redeneren ligt de echte trefzekerheid stelselmatig lager dan de aangegeven betrouwbaarheid. Bij classificatietaken en gereedschapskeuze is de kalibratie volgens AA daarentegen “relatief solide”.
Waarom zijn beslissingsmodellen goedkoper dan een LLM?
Een beslissingsmodel genereert geen sequentiële tokens als uitvoer. Het verwerkt de invoer één keer, berekent de kansverdeling over alle gestelde vragen tegelijkertijd en sluit de verwerking af. Daaruit vloeien drie duidelijke voordelen voort die terug te zien zijn in de metingen:
- Je betaalt louter voor de invoer. Geen kosten voor outputtokens of redeneertokens (reasoning tokens).
- Meerdere vragen in één aanroep verwerkt in plaats van afzonderlijke JSON-velden die token voor token moeten worden uitgeschreven.
- Reactietijden in honderden milliseconden. 0,06 tot 0,5 seconde per taak tegenover 1,4 tot 1,5 seconde bij compacte LLM’s in low-modus.
Het prijsverschil tikt fors door bij grote volumes. Specifiek op classificatie (WildGuardTest) berekende AA de kosten per miljoen taken op circa € 10,82 (12,1 USD) voor Decider en circa € 20,38 (22,8 USD) voor Jeva, vergeleken met circa € 81,78 (91,5 USD) voor Claude Haiku 5.5 (low).
Wanneer kies je voor een beslissingsmodel?
De inzet van zo’n model loont zodra je werkt met gesloten keuzelijsten en aanzienlijke volumes verwerkt:
- classificatie en automatische routering van helpdesktickets, e-mails en binnenkomende documenten,
- contentmoderatie van reacties en vroegtijdige detectie van riskante verzoeken,
- toolselectie binnen AI-agents en de afweging tussen “aanroepen” of “verduidelijking vragen”,
- geautomatiseerde kwaliteitscontroles: goedkeuren, bijsturen of doorzetten naar een medewerker.
Het loont niet wanneer actuele feitenkennis doorslaggevend is of wanneer er daadwerkelijk tekst gegenereerd moet worden. Op algemene kennisvragen bereikt Claude Haiku 5.5 (low) een accuratesse van 52% en GPT-6 Luna (low) 66%, tegenover slechts 28% tot 41% bij beslissingsmodellen. Ook een klantvriendelijk antwoord formuleren kan zo’n model niet; daar blijft een volwaardig LLM voor nodig.
Wat volgt
Artificial Analysis werkt de ranglijst doorlopend bij en nodigt AI-ontwikkelaars uit om nieuwe modellen aan te melden. Een overzicht met scores per deeltest, API-prijzen en onze eerdere evaluatie (die we in het Pools op Poolse klantvragen uitvoerden) staat gebundeld in het overzicht Beslissingsmodellen in AI. Eerder verschenen op deze site al analyses over Jev van TypeSafe, Cloudflare Clef en Strands Decider 2B van AWS.
Google · Jouw bronnenHoger in Google - met één klikToevoegen aan voorkeursbronnen →Bronnen
- Artificial Analysis: Artificial Analysis Decision Index v1.0 (13-10-2026)
- Artificial Analysis: Decision Index - live ranglijst (gegevens geraadpleegd op 13-10-2026)
- Artificial Analysis: methodologie van de Decision Index
- Artificial Analysis op X (bericht van 13-10-2026)
More on this from HELDER

 magazine·Zaak Thélyson Orélien: ik testte de roman met drie AI-detectors. Dezelfde alinea: 100%, 85% en 0%De zaak-Orélien uitgelegd en mijn test van romanfragmenten in Pangram, AUTHORRA en ZeroGPT, met Zola en een AI-tekst als controle.